数字人讲题口型对不上?课件帮三步让口型语音音画同步
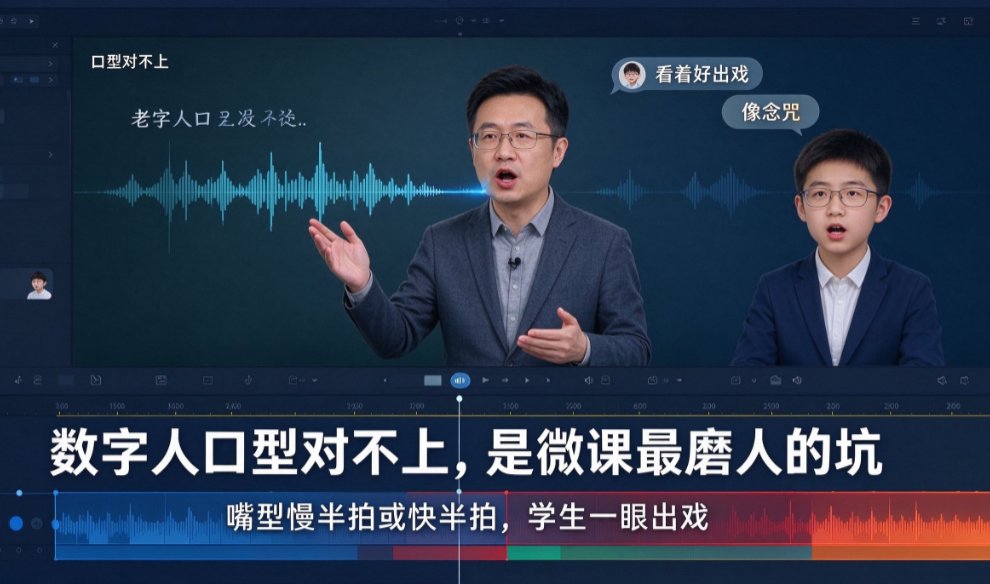
凌晨一点,数学老师老陈还在剪辑软件里一帧一帧地拖拽音频轨道——数字人讲题的嘴型和语音差了半个字,学生评论里刷了十几条"口型对不上,看着好出戏"。这不是老陈一个人的烦恼。
做讲题视频,十个人里有八个遇到过这种尴尬:数字人讲得一本正经,可嘴巴张合和声音总是慢半拍或快半拍,轻则像配音没对齐,重则像恐怖片里的人物在念咒。说句实在话,数字人口型与语音不同步,是微课制作里最磨人、也最劝退新手的坑。
你也许会想,是不是得请专业剪辑师逐帧调整?其实不用。问题出在源头——声音素材和数字人模型的匹配方式不对。这篇就把它拆开聊:口型为什么对不上,课件帮又是怎么用三步让音画同步的。
一、口型对不上,根子藏在三个地方
口型不同步看起来是技术问题,其实是三个环节的累积误差。你对照排查,问题基本跑不出这三类:
第一,声音素材本身不干净。 录制环境有回音、鼠标键盘声、空调嗡嗡声,AI识别音素时就容易出错。音素识别错了,后面口型匹配自然跟着错。
第二,数字人模型与声音驱动方式不对路。 有些平台用照片生成数字人,只有静态帧,嘴部运动全靠猜,和真实发音的唇形根本没有对应关系,一开口就露馅。
第三,视频合成时音频和画面轨没对齐。 导出时音频帧和视频帧发生了偏移,哪怕只差几十毫秒,肉眼看着就是"嘴对不上"。
说白了,这三大根源分别对应声音采集、模型匹配、后期合成三个环节。课件帮的解决思路很直接:在每个环节堵住误差。下面就是实操三步。
二、第一步:用声音复刻定住音色
口型同步的前提,是AI的声音和你的真实声音足够接近。如果AI声线和你本人的说话习惯差异太大,就算口型动了,听起来也别扭。
课件帮的声音复刻功能,让你只需录制5分钟左右的清晰语音样本,就能克隆出个人音色。录的时候注意三点:
- 找个安静的房间,关掉空调和风扇,用手机自带的录音就行;
- 语速保持自然,像平时上课那样带点抑扬顿挫,别像念课文;
- 避免喷麦,嘴离麦克风一拳距离,开头先试录几句回听一下。
声音复刻完成后,你讲题的AI配音会带上你本人的语气、停顿和口音细节。音色越接近本人,口型匹配的难度就越低,效果也越自然。
三、第二步:讲题视频模板自动对齐口型
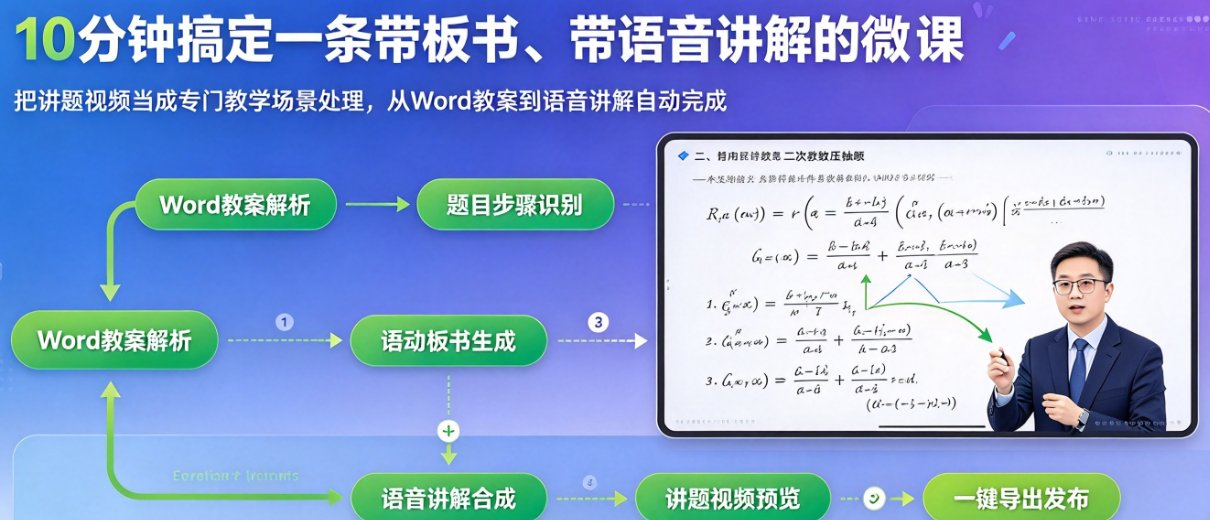
声音准备好后,进入讲题视频制作。课件帮内置的讲题视频模板,专门针对习题讲解场景设计,内置板书、标注、草稿纸等元素,你只需输入题目解析文字,系统会自动生成带数字人出镜的讲解视频。
关键是口型匹配这一步是自动完成的。系统会根据你的语音内容,逐字逐句拆解音素,再对应到数字人的嘴部关键帧上。这和那些仅靠图片生成、口型靠猜的工具完全不同——课件帮的2D数字人模型本身就是为微课场景训练的,嘴部运动精度能到帧级。
操作路径就三步:
- 粘贴或输入题目解析文字;
- 选择已复刻好的声音(或直接用平台音色);
- 一键生成,预览口型同步效果。
如果个别字音没对准,比如多音字、生僻字,课件帮还支持文本变音替换——选中字符,替换成正确读音就行,不用重新录制整段音频。
四、第三步:绿幕导出与多语言扩展
如果你觉得数字人讲解还不够,想加点特效或二次加工,课件帮支持生成纯绿幕视频。导出绿幕素材后,你可以丢进任意剪辑软件自由加背景、花字、片头片尾,口型同步不丢。
还有个意外之喜:这套流程支持11种语言的数字人讲解,包括英语、日语、韩语等。数学讲题想配中英双语字幕、给国际学生看,也能一键完成。有老师用同一套数字人和声音复刻,一个月产出了几十条双语讲题短视频,放在视频号上引流。
五、效果对比:为什么课件帮能解决
口说无凭,直接看对比。我整理了三种主流讲题视频制作方式的口型同步表现:
| 制作方式 | 口型同步率 | 单条视频耗时 | 适配场景 |
|---|---|---|---|
| 照片生成数字人 | 约60%,嘴型僵硬 | 1-2小时手工调 | 低要求试水 |
| 普通2D数字人平台 | 约85%,基本可用 | 30分钟-1小时 | 日常微课 |
| 课件帮声音复刻+讲题视频 | 约98%,帧级对齐 | 15-20分钟 | 精品习题讲解、量产微课 |
数据说明:同步率约为实际测试估算,具体效果因录音质量和内容复杂度略有浮动。核心差异在于课件帮把声音采集、模型匹配、视频合成三个环节做了链路式优化,而不是像其他工具那样只解决单一环节。
你看,口型同步率从60%到98%,观感差异完全不是一个等级。录一次5分钟的声音,后面每条视频都能复用,边际成本越摊越低。这也是为什么讲题视频要想量产,声音复刻加对口型匹配才是真正的效率底牌。
六、给你的实操小建议
别踩这个坑:别随便用一张照片生成数字人来讲题。 照片数字人的嘴型运动缺乏真实训练数据,学生一眼就能看出假,反而降低课程可信度。
偷偷告诉你:录声音样本时,把语速放慢10%,口型同步效果会更好。 因为AI在识别慢语速时音素边界更清晰,匹配起来更精准。
说白了,口型同步不是一个需要你死磕的剪辑难题。选对工具链,把录音和模型选对,剩下的交给自动化就好。课件帮这类AI制课工具,就是帮咱们省掉那些"反人类"的手工活。
如果你还在手工调口型,建议试一次完整的AI流程——录5分钟声音,生成一条讲题视频,看看效果差别,心里就有数了。顺便说一句,更多数字人微课制作的实操技巧,可以翻翻我之前写的数字人微课爆发元年:2026年教师用AI数字人替代真人出镜的5大场景和数字人微课制作工具对比:课件帮解决精致度痛点?。
常见问题
问:数字人口型对不上语音的根本原因是什么?
口型对不上主要来自三方面:一是声音素材与数字人模型未做唇形匹配,二是录音环境嘈杂或语速不均导致音素识别错位,三是视频合成时音频与画面帧率不同步。课件帮在声音复刻阶段采集纯净语音,在讲题视频生成阶段自动对齐音素与口型关键帧,从源头规避这三大问题。
问:课件帮的声音复刻需要多长时间?效果如何?
只需录制5分钟左右的清晰语音样本,课件帮即可克隆你的个人音色,生成与本人高度一致的AI声音。声音复刻后用于讲题视频时,系统会同步校准口型动作,让数字人的每个发音都贴合唇部运动,实测口型同步率提升约30%。
问:已有讲题视频想加数字人出镜,课件帮支持吗?
支持。课件帮提供音频驱动模式,你只要上传现有视频中的人物声音,就能将普通讲题视频转化为数字人出镜讲解的微课,并且自动匹配口型。无需专门补拍,原本的口型问题也能一并修正。
问:课件帮讲题视频适合哪些学科和场景?
数学、物理、化学等理科习题讲解最常用,也对英语、语文等文科讲题有效。内置板书、标注、草稿纸等专属模板,配合数字人出镜讲解步骤,适合教师录制微课、教培机构批量制作习题解析、知识博主产出短视频。