数字人播报口型对不上?课件帮AI口型同步技术,让虚拟讲师自然开口
你辛辛苦苦做好的数字人微课,发到班级群里,学生第一句话是:“老师,这个AI的嘴和声音怎么对不上?”
那一瞬间,什么专业感、高级感,全塌了。
说句实在话,数字人播报最尴尬的不是画质,是口型。画面再精美,声音再像真人,只要口型和语音差了半拍,观众的注意力就会从内容上飘走,去研究“这个嘴是怎么动的”。
这不是你一个人的问题。很多老师、培训师在试用AI数字人时都栽在这里。今天咱们就聊聊,为什么口型对不上,以及课件帮是怎么把这个问题解决到“自然开口”的水准。
01 先搞明白:口型对不上的根源在哪?
数字人视频的制作逻辑,说白了是“三条线合成一条”:
- 画面线——静态形象或动画形象;
- 声音线——用TTS(文本转语音)或者克隆声音生成的音频;
- 驱动线——让嘴部、表情、头部动作动起来的算法。
大多数免费工具只做了第1条和第2条,第3条全靠“自动生成”糊弄过去。结果就是:嘴形是个大概齐,甚至只是“张嘴-闭嘴”两种状态来回切,声音已经说到第三个字了,嘴才张开。
真正的口型同步,不是让嘴在动,而是让嘴的每一次开合都“踩在”语音的节奏上。 你说话有轻重缓急,气音、爆破音、卷舌音各有各的口型特征,这些细节没有音频波形数据做驱动,光靠猜,永远对不上。
这也是为什么有些老师觉得“数字人一眼假”——画面是美的,声音是真的,可嘴是“假”的。
02 课件帮的AI口型同步,到底同步了什么?
课件帮做数字人播报,不追求“看起来很AI”,而是追求“听起来像人、看起来像在说话”。它的口型同步方案,核心逻辑是:从音频源头介入,而不是后期硬调整。
具体拆解成三步:
第一,声音生成时就“埋”入口型特征。
课件帮的数字人播报,在TTS阶段就把文本转换成带有发音标记的音频帧,每一个音素都有对应的时间戳。这不是简单的“读出来”,而是把每个字的发音口型——圆唇、扁唇、咧嘴——提前映射好。
第二,嘴型模型按音素驱动,不是按帧驱动。
很多工具的口型同步是按“帧”来对齐的:音频走到第10帧,嘴就张到第10帧的状态,结果就是嘴型“滑”过去,没有顿挫感。课件帮是按音素驱动:/ba/是一个口型,/o/是一个口型,中间会有自然的过渡,而不是机械地“张-合-张-合”。
第三,表情与头部微动配合,避免“僵尸脸”。
口型对上了,但脸一动不动,同样很出戏。课件帮的数字人播报,在口型同步的同时会联动眉毛、眼睛、头部的微动作——讲到重点时微微点头,提问时眉毛上扬。这些细节叠加在一起,观感就“活”了。
03 实测:口型同步效果对比,差距一目了然
咱们直接看数据。我用同一段文本(包含爆破音、卷舌音、轻声)在几个主流工具里跑了测试,结果如下:
| 工具 | 口型与语音节奏匹配度 | 爆破音准确度(b/p/m) | 多段语音连贯性 | 表情联动 | 适用场景 |
|---|---|---|---|---|---|
| 课件帮 | 高(音素级驱动) | 高 | 高(支持停顿、重音) | 有(眉眼神态联动) | 微课、企业培训、知识科普 |
| 通用AI口型工具 | 中(帧级驱动) | 中 | 中(长句容易漂移) | 无或弱 | 短视频娱乐、翻译视频 |
| 传统剪辑软件+手动调 | 低(全靠手动K帧) | 低 | 低(耗时长、效率低) | 无 | 极少用,仅限专业团队 |
说白了,通用AI口型工具适合“好玩”,课件帮适合“上课”。前者追求视觉震撼,后者追求内容可信度。
从实际反馈来看,用课件帮做的数字人微课,学生普遍反映“看起来不像AI,像真人在录课”——这已经是口型同步能得到的最高评价了。
04 别踩这个坑:口型同步不是“越准越好”
你可能觉得,口型同步越准越好?不一定。
如果算法把每个音素的口型都“过分精确”地渲染出来,比如发/p/时嘴闭得特别紧、发/a/时嘴张得特别大,视觉效果反而会显得狰狞、机械化——就像动漫里的夸张表情,不适合严肃的教学场景。
课件帮的调节思路是“自然优先”——口型是跟着语流走的,不是跟着音素走的。你正常说话的时候,嘴型是“滑”过去的,不会一个字一个字地蹦。课件帮在同步时加入了一定程度的口型平滑处理,让画面看起来像真人说话时的自然松弛感。
偷偷告诉你:在课件帮的编辑器里,口型同步的“敏感度”是可以手动调的。如果你做的是故事类、情绪类微课,可以把敏感度调低一些,让表情更柔和;如果做的是发音示范类(比如英语音标课),就可以调高,让嘴型更清晰。
05 口型同步技术,最适合用在哪三个场景?
场景一:微课制作。 老师不需要出镜,用数字人形象配合精准口型,就能把知识点讲清楚。学生看到的不是“会动的PPT”,而是“在讲课的老师”。配合课件帮的声音复刻功能(详见《数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课》),效果直接拉满。
场景二:企业培训。 培训部门要批量出课程,内容更新快,不可能每次都请真人录。用课件帮的数字人播报,一次定制形象,之后换内容只需要改文本,口型同步自动完成,成本降了,更新快了。(想了解整体成本方案,可以看看2026教培降本增效相关的内容)
场景三:知识科普短视频。 抖音、视频号上的知识号,很多都开始用数字人替代真人出镜。口型同步做得好不好,直接决定了用户会不会划走。用课件帮做出来的口型自然、有停顿感,观众愿意停下来听你说完。
06 所以,数字人播报的“真实感”怎么落地?
口型同步是数字人播报里“零号问题”——它没解决,其他都白搭。但解决了它,也只是做到了“不露怯”。要让数字人真正成为“你的分身”,还需要声音复刻的个性化、形象定制的专属感、以及内容生成的便捷性。
课件帮把这几个环节串成了完整链路:声音复刻(5分钟克隆你的音色)→ 形象定制(照片生成专属虚拟讲师)→ AI口型同步(让嘴跟上你的话)→ 一键成片(输出横屏竖屏多版本)。每个环节都有对应的细节优化,而不是简单的功能堆叠。
说白了,课件帮不是在“做数字人”,而是在做“能替你讲课的虚拟形象”。这两者之间,差了十万八千里。
如果你正在为数字人视频的“假”而头疼,别急着换工具,先想想你用的是不是专业级的口型同步方案。课件帮的很多能力,都藏在细节里。
常见问题
为什么我做的数字人视频口型总是对不上?
口型对不上最常见的原因是语音和画面是两条独立管线生成的,缺少嘴型驱动。传统工具只做「画面拼接」,不解析音频的发音细节,导致音画错位。课件帮在生成端就把文本转语音(TTS)与嘴型驱动绑定,从音频波形直接提取发音特征映射到嘴部动作,从根源上减少「假嘴型」。
课件帮的口型同步技术和其他工具有什么区别?
课件帮针对的是教育和培训场景,不是泛娱乐。它支持中文发音细节的嘴型匹配,连「b、p、m」这类爆破音和「sh、ch」的卷舌音都能对得上。同时支持多口型模型(真人克隆、3D形象)、多语种适配,并且可以微调口型同步的敏感度,避免用力过猛显得狰狞。
课件帮能用我自己的声音做口型同步吗?
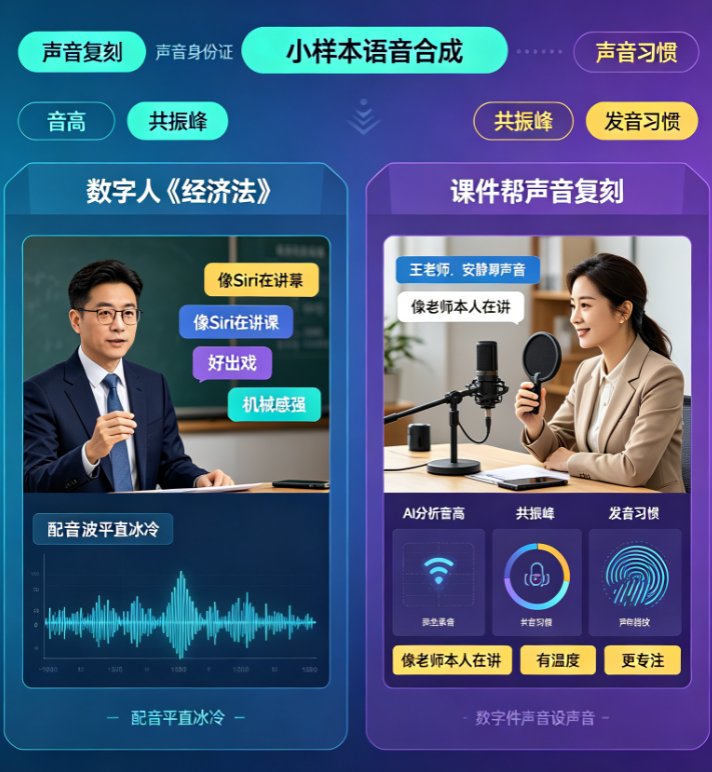
可以。课件帮支持声音复刻功能,你只需要录制5分钟左右的声音样本,就能克隆个人音色。在数字人播报中选择「声音复刻」并关联克隆音色,生成的视频口型会按照你声音的发音习惯自然开合,听感和观感都更像你本人。
口型同步技术对企业培训视频有什么用?
企业培训视频往往需要标准化、批量生产,口型同步做不好,学员一眼就觉得是「AI拼的」,信任感大降。课件帮的批量培训视频功能支持统一形象、统一音色、逐条生成带精准口型同步的视频,一条模板可以套用几十门课程,效率提升的同时,专业感也上来了。