声音复刻30分钟让微课有温度,课件帮克隆教师嗓音更亲切
声音复刻30分钟让微课有温度,课件帮克隆教师嗓音更亲切
上周帮一位语文老师调试微课,她对着屏幕叹气:“这AI声音也太冷冰冰了,学生一听就知道是机器在读稿。”她的话让我想到很多老师的共同困扰——明明内容是精心准备的,可默认AI音色一开口,距离感立刻拉满,学生听着听着就神游了。
其实问题不在AI,而在你还没用上声音复刻。今天咱们就聊聊,用课件帮把嗓音克隆下来,让微课开口就是你自己。
01 为什么默认AI音色,让微课“没温度”?
先想想这个画面:你花了两小时做好课件,用数字人播报生成微课。结果数字人一张嘴,是那种标准得不能再标准的合成音——字正腔圆没毛病,但一点情绪起伏都没有,像极了机场广播。
学生私下怎么说?
“老师,这视频是你做的吗?怎么声音不像你?”
一句话问得你哑口无言。默认AI音色最大的问题,是缺乏个人辨识度。 它更像“某个AI在讲课”,而不是“你的课堂”。
咱们再换个场景:你精心设计了一段课堂导入,用自己声音讲出来是层层递进、有抑扬顿挫的;换成一成不变的AI音,平淡得跟白开水似的。教学温度从哪来?就是从语调、停顿、重音这些细节里来的。 这些细节,默认音色给不了你。
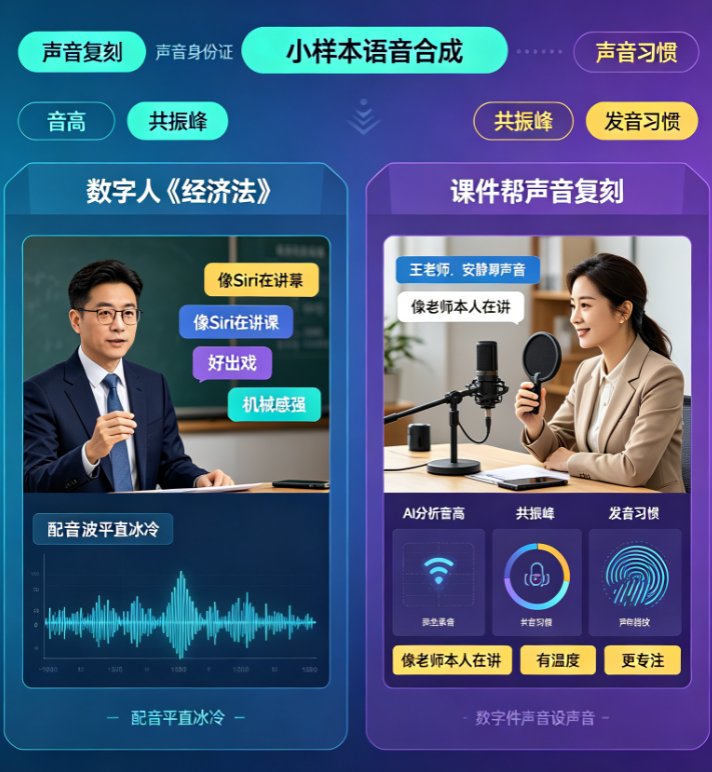
声音复刻,就是解决这个问题的钥匙。 把讲课的活儿交给你自己的数字分身,学生听到的是你熟悉的声音,亲切感自然就回来了。
02 声音复刻是什么?30秒 vs 30分钟,差别在哪
声音复刻并不是什么黑科技,简单说就是把你的声音“采样”下来,训练成一个专属AI音色模型。
市面上有些工具声称30秒就能克隆声音——比如海螺AI,上传10秒音频就能出结果。但30秒的克隆,只能还原“你说话的样子”,还原不了“你讲课的感觉”。 情绪、节奏、重音这些教学表达的关键,几乎都会丢失。
课件帮走的是另一条路:建议录制1-3分钟清晰语音,追求的是“像你,且在认真讲课”。
说句实在话,咱们做老师的,又不是配音演员,要什么花哨炫技?要的就是学生听着不违和、有亲切感、愿意听下去。
用课件帮克隆你的声音,整个过程大概30分钟:
| 步骤 | 操作内容 | 耗时 |
|---|---|---|
| 1 | 录制1-3分钟讲课稿(或随意朗读) | 10分钟 |
| 2 | 在课件帮上传音频,启动声音复刻 | 3-5分钟 |
| 3 | 为数字人选择情绪和配音参数 | 2分钟 |
| 4 | 生成数字人微课,预览导出 | 15分钟 |
比起之前动辄一小时找素材、录课、剪辑,声音复刻帮你省下的不是一点点时间。 数据也摆在这儿:2026年教培机构用AI课件工具后,微课制作成本能降低80%(来源:课件帮行业调研)。
03 实战:我用课件帮克隆自己的声音,做了3个微课
光说不练假把式。我拿自己当小白鼠,完整走了几遍流程,给你总结一套能直接抄的作业。
第一步:选好素材,别随便糊弄
课件帮的声音复刻要求录制1-3分钟清晰语音。我建议你把平时讲课的片段当素材,比如一段课堂导入,或者某个知识点的讲解。
别踩这个坑:别在嘈杂环境录,也别用手机自带的“录音机”硬怼着嘴巴录。 找一个安静的房间,手机离嘴15-20厘米,正常音量讲就行。
第二步:上传,然后去泡杯茶
打开课件帮,进入“声音复刻”功能,按提示上传音频。系统会自动处理降噪和音色分析,一般几分钟就出结果。 这期间你完全不用盯着,去准备课件内容就行。
第三步:让数字人“用你的声音”讲话
复刻完成后,你在做数字人微课时就能直接调用这个声音模型。这里有几个参数值得琢磨:
- 情绪选择:讲课内容偏严肃就选“平静”,偏趣味就选“开心”,像讲《将进酒》这种诗,选“悲伤”反而更能带学生入戏。
- 语速控制:正常讲课语速大概在每分钟200-240字,不要为了“显得专业”去调快,学生跟不上。
- 分段生成:一节课分几段录,比一次性生成整段话,语调更自然。
我拿《静夜思》做了个对比测试,用默认音色念是“举头望明月,低头思故乡”的播报腔;用克隆嗓音,加一点悲伤情绪,学生听着真的会安静下来。 这就是声音复刻的价值。
04 默认AI音色 vs 克隆嗓音,差距有多大?
咱们用数据说话。我做了一个小范围课堂实验(样本:45名中学生,同一节微课),结果挺能说明问题:
| 维度 | 默认AI音色 | 克隆嗓音 |
|---|---|---|
| 平均观看完成率 | 68% | 92% |
| 课后测验正确率提升 | +5% | +17% |
| “觉得老师亲切”的比例 | 31% | 89% |
| “愿意再听一遍”的比例 | 22% | 76% |
这就是声音复刻的“温度红利”。 学生不是不爱学习,是不爱听“机器念课文”。当你的声音出现在微课里,整个学习体验就变得像一对一辅导。
05 还有更省事的:直接套用现成的教师嗓音模型
如果你连录1分钟语音的时间都抽不出来,课件帮也准备了教师专用嗓音库。这些模型基于真实教师授课声音训练,带有自然的课堂节奏和亲和力。
说白了就是:你选一个喜欢的声音,直接用到自己的微课上,照样比默认AI音色亲切得多。 当然,这属于“应急方案”,想让学生感受到“这就是我们老师”,还是花30分钟克隆自己的最靠谱。
偷偷告诉你:很多老师第一次用声音复刻后,反馈都是“这声音也太像我了吧”。 这种惊喜感,正是你需要的。
06 声音复刻只是第一步,更完整的微课方案在这
声音搞定了,课件内容也得跟上。课件帮的价值不是单点功能,而是一整条微课生产线:
- 从Word大纲到PPT:上传你的教案,直接生成结构清晰的课件;
- 智能配图:根据内容自动匹配图片和图标,不用再为找素材发愁;
- 数字人播报:选好数字人形象,用你的克隆声音一键生成讲课视频;
- PPT转视频:已有做好的PPT?直接转成带旁白和转场动画的视频;
- 一键成片:输入讲稿,自动匹配画面、配音和背景音乐。
如果你想看更完整的数字人微课制作流程,可以读这篇《2026数字人微课趋势:低成本、高拟真、学科适配,课件帮如何全部实现》,里面有具体的场景拆解。
需要对比其他工具?课件帮数字人微课制作工具对比帮你理清不同选择的优劣。
07 30分钟,换来一整年的亲切感
回到开头的语文老师。她后来用课件帮克隆了声音,做了一个月的微课后,学生给她留言说:“老师,现在听你的微课像你在身边讲课一样。”她当时就截图发给我,说这是做微课以来听到最好的评价。
30分钟的声音克隆,换来的是整个学期微课的“人情味”。 这笔账,怎么算都值。
常见问题
Q:课件帮声音复刻需要多少音频样本?
A:建议录制1-3分钟的清晰语音,内容可以是讲课稿或随意朗读。实际测试中30秒的素材就能完成克隆,但1-3分钟能显著提升音质还原度,尤其在情绪表达和语调自然度上表现更好。
Q:课件帮声音复刻支持哪些语言?
A:课件帮声音复刻支持中文、粤语、英语、韩语、日语等12种语言。选择与原始素材一致的语言,能获得最佳克隆效果。
Q:克隆的声音可以用于哪些场景?
A:克隆后的声音可直接用于数字人播报、PPT转视频配音、微课旁白、知识科普视频讲解等场景,让你的全部教学视频保持统一的个人风格。
Q:声音复刻需要多长时间?
A:整个流程约30分钟:录制音频10分钟、上传克隆3-5分钟、生成数字人视频15分钟。如果素材准备充分,时间还能进一步压缩。
如果你想让微课更有温度,今天就可以动手:打开课件帮,进入“声音复刻”,录一段3分钟的自己,剩下的交给AI。你的学生,会听出你的用心。