照片数字人1小时生成?课件帮数字人定制,教师不出镜也能开讲
别再让录课吃掉你的周末
上周和一位在重点中学教物理的老同学吃饭,她一边扒饭一边跟我吐槽:学校要求每位老师每学期产出8节微课,她这学期已经连续三个周末泡在录课室里了。
“你知道最痛苦的是什么吗?”她放下筷子,“每次面对镜头就紧张,NG十来次才能说顺一段。 明明在课堂上讲得挺好,一对着摄像头就语无伦次。而且录完还要剪辑、加字幕,一节10分钟的微课,前前后后要折腾一整天。”
这不是个例。视频数字人定制周期长、成本高,真人出镜又耗时耗力,这两难几乎卡住了所有想做微课的教师。
但就在上个月,这位物理老师用半天时间做了件事:上传了一张证件照,1小时后拥有了一个和她高度相似的数字人分身,然后花20分钟输入讲义,生成了一节“她”出镜讲解的微课视频。
她说:“我终于可以不用出镜讲课了。”
一、教师做微课,最贵的成本不是钱,是时间
咱们先算一笔账。
一节真人出镜微课,从备课、背稿、化妆、布景、录制到剪辑,少说要5到8个小时。如果NG多,一整天就交代了。
更别提很多老师坦言——面对镜头会紧张、表情不自然、语速失控,这些“非专业主播”的硬伤,根本不是练几遍就能解决的。
传统的数字人定制呢?动辄需要专业团队上门拍摄、3D建模、动作捕捉,周期以周为单位计算,费用更是高达数万元。对普通老师来说,这门槛实在太高。
痛点很清楚:想做出镜微课,但没时间、没设备、没团队,甚至没勇气面对镜头。
解决方案也很清楚:用一张照片,生成一个属于你自己的数字人。
结果:出镜这件事,从“亲力亲为”变成“一键代劳”。
二、1小时内,从照片到专属数字人
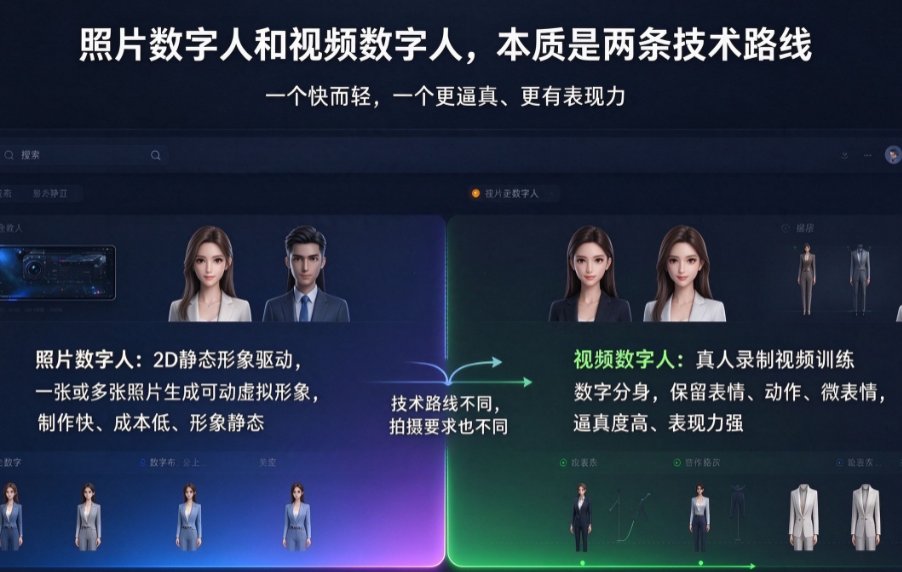
课件帮的照片驱动数字人定制方案,突破了传统3D建模的成本和时间瓶颈。 你只需要上传一张清晰的正脸照片,AI会自动完成面部特征提取、3D形象重建、表情绑定和动作驱动。
整个流程,最快1小时交付可用形象。
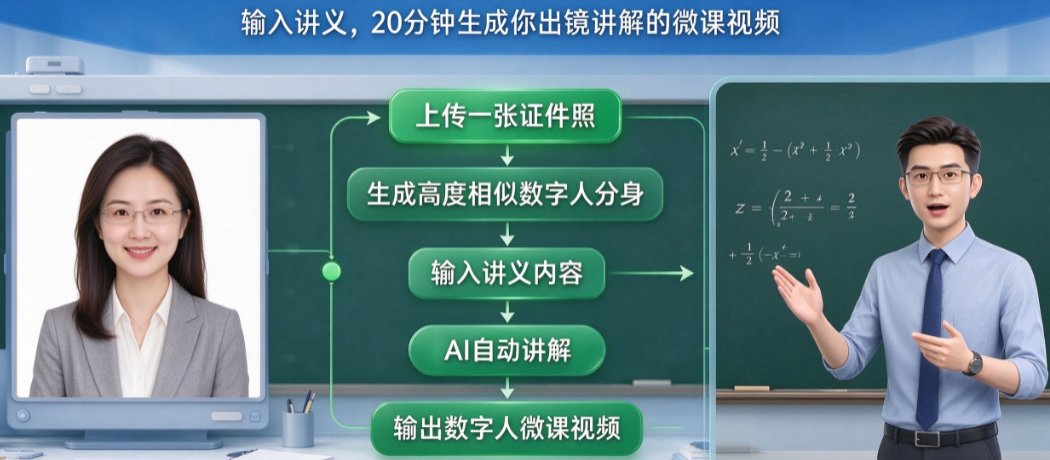
这背后是深度神经网络对面部结构、纹理、微表情的多维度复刻。说句实在话,和真人的相似度达不到100%,但用在微课、培训视频里,已经足以以假乱真。
别踩这个坑: 有人会问,是不是随便一张手机自拍就行?建议尽量用正面、光线均匀、无遮挡的清晰照片,分辨率越高,生成效果越好。你总不能指望一张糊成马赛克的照片生成一个高清数字人吧?
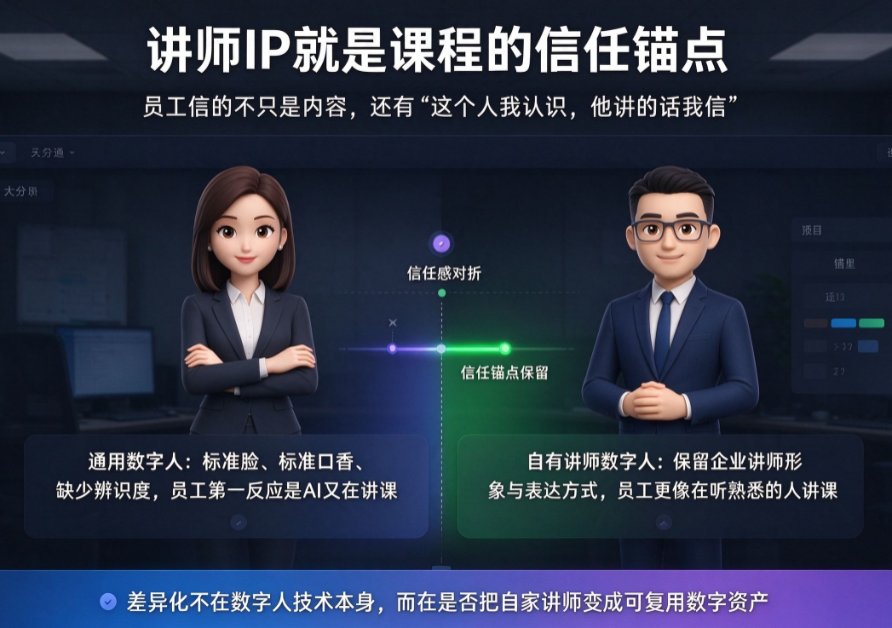
课件帮的数字人定制不仅支持形象生成,还打通了声音复刻能力——录5分钟语音样本,就能克隆你的音色。也就是说,数字人可以“用你的声音”讲“你的课件”,学生看的时候,感觉就像你本人在上课。
这不只是解决“出镜”问题,更是把“个人IP化”的门槛拉到了地板上。
三、真人出镜 vs 照片数字人:一张表看懂差距
对比一下,你就明白为什么越来越多老师转向照片数字人方案:
| 对比维度 | 真人出镜录制 | 传统数字人定制 | 课件帮照片数字人 |
|---|---|---|---|
| 前期准备 | 背稿、化妆、布景、调试设备 | 团队上门拍摄+3D建模 | 仅需1张清晰照片 |
| 制作周期 | 5-8小时/节 | 数周起 | 最快1小时 |
| 成本投入 | 设备+时间+精力 | 数万元起 | 百元级 |
| 出镜压力 | 高,易紧张NG | 无 | 无 |
| 内容更新 | 每次需重录 | 模型可复用 | 形象复用,随时生成新视频 |
| 个性化程度 | 取决于本人状态 | 高 | 高(可配合声音复刻) |
说白了就是:真人出镜费时间,传统定制费钱,而照片数字人几乎把两头的门槛都砍掉了。
从长远看,数字人形象一旦建好,就是你的“永久员工”——只需输入讲义,AI就驱动它出镜讲解,几分钟生成一节课。
这条路径,对教师、培训师、知识付费创作者都适用。尤其适合以下场景:
- 微课制作:一学期十几节微课,不再占用周末
- 企业培训:产品介绍、流程演示、新人入职,持续输出不累
- 知识科普:竖版短视频批量生产,适配抖音、视频号
- 讲题视频:自动生成带板书、标注的习题讲解
四、从“不出镜”到“出好片”:完整工作流
照片数字人只是个开始。课件帮真正厉害的地方,是打通了从课件到视频的全链路自动化。
偷偷告诉你我的实操路径:
- 用课件帮AI生成PPT课件(或直接导入Word大纲)
- 上传照片生成数字人形象(约1小时)
- 克隆自己的声音(5分钟语音样本)
- 输入讲稿,驱动数字人播报
- 一键成片,导出微课视频
整个过程,从零到一节完整微课,半天内就能交付。对比以前录一整天还未必满意,效率提升了不止一个量级。
有个做企业内训的朋友跟我反馈,她用课件帮数字人给公司做的产品培训视频,同事居然没看出来是AI生成的,“还以为我偷偷去演播室录的”。当数字人足够自然,你就不需要再解释“这是AI”了——它已经融入你的日常工作流。
五、趋势已经来了,别等到被卷才动
2026年,数字人微课已进入爆发元年。从高校精品课到中小学微课大赛,从企业培训到知识带货,用照片生成数字人讲师正在成为内容生产的基础设施。
课件帮做的事情,本质上是把「虚拟教师制作门槛」降到了“人人可用”的层级。不是每个老师都懂3D建模,不是每个机构都请得起专业团队,但每个老师都有一张照片。
当工具足够简单,内容创作就不再是少数人的特权。
如果你也想摆脱录课室的束缚,不妨从一张照片开始。1小时后,你就有了一位不用休息、不会NG的专属数字分身。
课程在更新,技术在迭代,你的形象和声音,可以一直陪着你“上课”。
常见问题
课件帮照片数字人真的能1小时生成吗?
是的。课件帮基于照片驱动的AI形象生成方案,上传一张清晰正面照后,系统自动完成面部建模、表情绑定和动作驱动,最快1小时即可生成可用的数字人形象。与传统3D建模动辄数周相比,效率提升非常明显。
上传的照片有什么要求?会不会生成得很假?
建议使用正面、光线均匀、无遮挡的清晰照片,分辨率越高效果越好。课件帮的AI模型会对面部特征进行多维度重建,生成的形象在表情、嘴型同步上的自然度已经达到商用级别。当然,和真人相比仍有细微差异,但用于微课、培训视频完全够用。
数字人定制后,声音怎么处理?
课件帮支持声音复刻功能,录制约5分钟的语音样本即可克隆个人音色,让数字人以你的真实声音讲课。也可以使用系统内置的多种AI配音音色,满足不同场景需求。
照片数字人能用于哪些教学场景?
适用范围很广:微课视频、企业培训课件、知识科普视频、讲题视频、PPT转视频等。只要是需要讲师出镜的内容,都可以用数字人替代真人录播。
生成后可以修改形象或更换背景吗?
课件帮支持对数字人形象进行二次调整,例如更换服装风格、调整表情参数等。生成视频时也可以自由选择背景模板或自定义场景,无需重新建模。