声音复刻要多久?课件帮如何用30秒语音克隆个人声音做配音
你熬夜录过微课吗?晚上十一点,孩子睡了,你躲在书房,对着手机一遍遍念台词。嗓子哑了,情绪废了,最后出来的音频还是有喷麦声。第二天上课,学生说:"老师,你这声音听起来好疲惫。"
说句实在话,这种场景在过去十年里反复上演。但2026年,这件事有了新解法——声音复刻。不用麦克风、不用录音棚、不用死磕每一句的语调,只需要你正常说30秒的话,AI就能把声音"借"走,替你完成所有配音工作。
今天咱们不聊虚的,直接回答四个问题:声音复刻要多久?效果像不像?怎么操作?跟别的工具比好在哪?
01 声音复刻到底要多久?答案可能比你想的快
先给结论:声音复刻通常只需要30秒左右的音频素材,等待几十秒就能生成声音模型。
这不是某个实验室的夸张宣传,而是目前主流工具的真实水平。比如海螺AI的Audio模块,上传30秒语音后,几十秒内就能克隆出一个可用声音。课件帮的声音复刻功能同理,建议录制1-3分钟清晰语音,从上传到使用全程不超过5分钟。
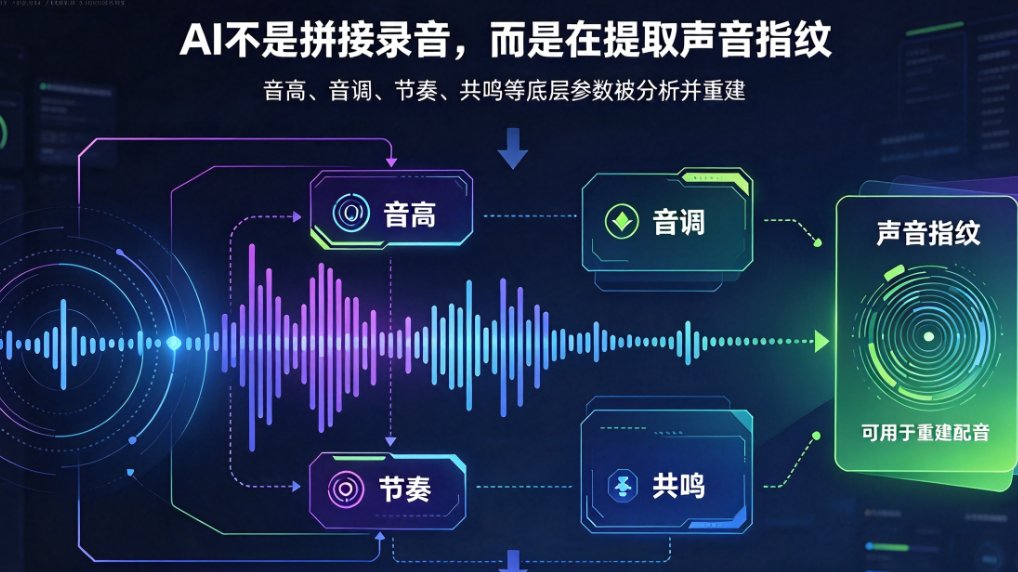
为什么这么快?说白了,AI声音克隆的原理不是"拼接录音",而是提取特征——分析你的音高、音调、节奏、共鸣这些底层参数,然后重建一个"声音指纹"。数据够了,模型就能模仿你说话。
这里有个关键误区要先说清:不是录音越长效果越好。
| 音频时长 | 适合场景 | 效果表现 |
|---|---|---|
| 5-10秒 | 基础复刻、一句话配音 | 音色相似度一般,情绪平淡 |
| 30秒左右 | 日常微课、短视频配音 | 音色还原度高,情绪基本保留 |
| 1-3分钟 | 精品课程、对外发布内容 | 音高、语调、节奏高度还原,情绪丰满 |
| 超过5分钟 | 几乎无额外提升 | 边际效益递减,徒增等待时间 |
别踩这个坑: 别为了"更像"硬录10分钟。AI模型对特征的提取在1-3分钟就饱和了,多录的时间只是浪费你的嗓子。
02 30秒语音克隆实操全流程:从录音到使用的四个步骤
以课件帮为例,整个操作流程清晰得不像一个AI工具:
第一步:录制语音样本 打开课件帮,进入"声音复刻"功能,按提示录制一段1-3分钟的清晰语音。环境安静点,手机自带麦克风就行,不用专业设备。
第二步:选择复刻级别 课件帮提供基础复刻和高级复刻两个选项。基础版几秒音频就能用,适合临时配一句旁白;建议选高级复刻,30秒以上音频,音质和情绪还原度明显更好。
第三步:等待生成 上传后大约几十秒,声音模型就训练好了。你可以立刻试听,感受下像不像自己。
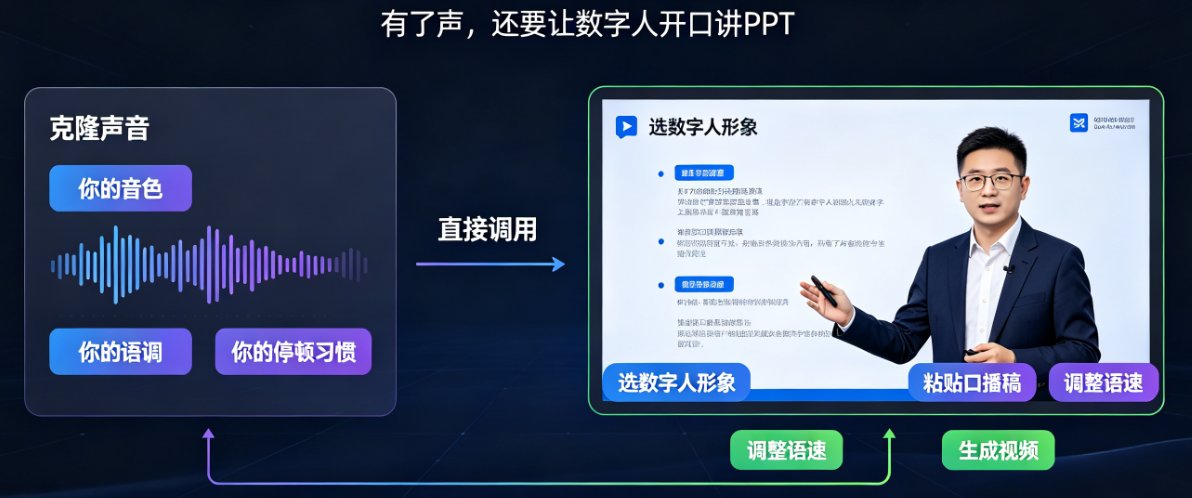
第四步:应用到场景 生成的声音自动保存在你的账户里,可以直接在数字人播报或PPT转视频功能中调用。
偷偷告诉你:很多老师第一次听到克隆声音时都会愣一下,因为太像了。那种"另一个自己替自己干活"的感觉,确实有点奇妙。
03 横向对比:课件帮 vs 海螺AI vs Voicv,谁更适合教学场景?
市面上能做声音克隆的工具不少,但针对教学场景的适配度天差地别。咱们直接拉出来遛遛:
| 对比维度 | 课件帮 | 海螺AI | Voicv |
|---|---|---|---|
| 最小音频样本 | 几秒(基础版) | 10秒 | 10秒 |
| 推荐音频时长 | 30秒-3分钟 | 30秒-5分钟 | 30秒 |
| 中文效果 | 强(普通话+方言) | 强(强调情绪还原) | 中等 |
| 情绪切换 | 支持多情绪 | 支持6种情绪 | 不支持 |
| 数字人播报集成 | 原生支持 | 有但需另配 | 无 |
| PPT转视频集成 | 原生支持 | 无 | 无 |
| 教学场景适配 | 模板+素材库加持 | 通用工具 | 通用工具 |
| 用户门槛 | 面向教师,操作极简 | 面向创作者,需学习 | 面向开发者 |
说白了就是: 海螺AI和Voicv是"万金油"工具,功能很强但需要你自己拼装;课件帮是"一体化"工具,声音复刻出来直接喂给数字人和PPT转视频,不用倒腾数据。
对教师而言,省下的时间比功能多少更值钱。你用海螺克隆完声音,还得导出音频、导入剪辑软件、对准时间轴;课件帮里,克隆完选个模板,点生成,完事。
04 声音复刻用在哪些教学场景?这5个方向值得收藏
光有工具,不知道用在哪也是白搭。结合一线老师的反馈,这几个场景是声音复刻的"高频刚需":
1. 数字人微课配音 录课时不想出镜?用克隆声音配合数字人形象,学生听到的是你的声音,看到的是虚拟形象,既保持亲切感又省去化妆布景。
2. PPT转视频讲解 把课堂PPT转成带旁白的讲解视频,过去要自己一句句配音,现在30秒样本让PPT自己"开口说话"。
3. 多角色对话演示 语文课分角色朗读,数学课情景题对话,用克隆声音配合不同情绪,一个人演完整台戏。
4. 录屏课补录 网课录到一半卡壳了?不用重录,用克隆声音补上那几句话,音色无缝衔接。
5. 系列课程统一音色 多章节课程分多天录制,嗓子状态难免波动。统一用克隆声音,整个系列音色稳定一致,强迫症友好。
05 关于声音复刻,你还需要知道的3件事
第一,声音克隆有版权和伦理边界。别拿别人的声音(尤其是公众人物)乱做内容,商用前务必确认权属。课件帮等正规工具都会在协议里明确使用边界,你用自己的声音做课程没问题,但"克隆唐国强读将进酒"就只适合自己乐呵,别公开发布。
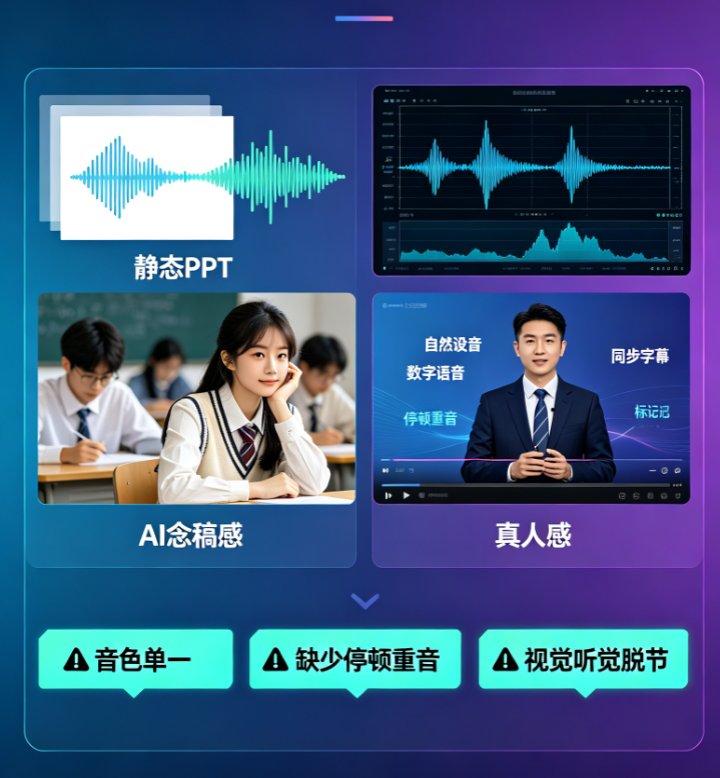
第二,情绪表达是关键差异点。早期AI声音像念稿,现在好工具能还原情绪起伏。课件帮支持多情绪切换,给语文朗读、历史故事这类课程提供了极大便利。
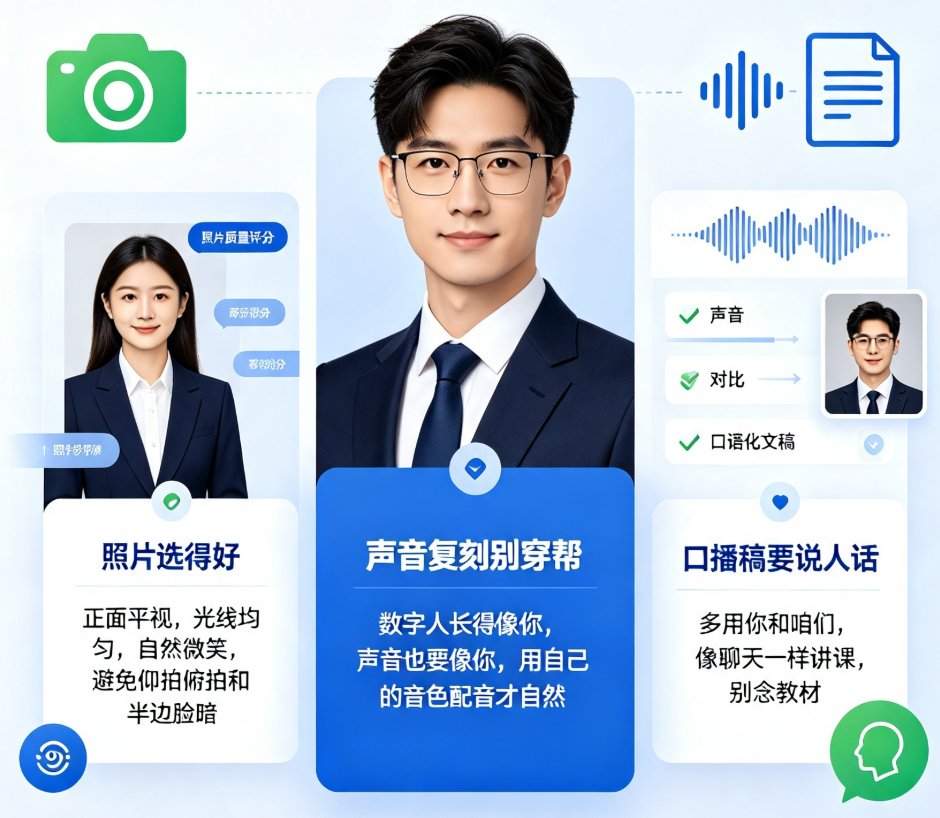
第三,声音质量和原始素材强相关。素材里喷麦、底噪大,克隆出来也会带杂音。录制时选安静环境、保持手机离嘴15-20厘米,是性价比最高的"降噪"手段。
【此处插入图表:柱状图展示不同音频长度对应的克隆相似度评分,30秒达到85分,1分钟达到92分,3分钟达到95分,5分钟后趋平】
想深入了解声音复刻与数字人结合的教学玩法,可以看看这几篇实操文章:
- 数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课
- 声音不像自己不像老师?课件帮声音复刻克隆个人音色只需5分钟
- 2026数字人IP化趋势:课件帮如何用声音复刻与形象定制打造专属教学助手?
- 2026年数字人微课个性化趋势:声音复刻+形象定制,课件帮如何让每位教师拥有专属数字人?
常见问题
问:声音复刻到底需要多长的音频素材? 答:基础复刻最短几秒钟即可,但推荐录制30秒左右的清晰音频,这样音色相似度和情绪还原度最高。课件帮建议录制1-3分钟效果更佳,超过5分钟对质量提升不大。
问:课件帮声音复刻支持哪些语言? 答:课件帮声音复刻主要针对中文优化,支持普通话及常见方言,同时覆盖英语、日语等主流语言,可满足教师双语教学或国际课程需求。具体语言列表可在功能页面查看。
问:克隆的声音能用在哪些地方? 答:克隆的声音可直接用于数字人播报、PPT转视频配音、图文短视频制作等场景,与课件帮其他功能无缝集成,一次克隆,多处复用。
问:声音复刻结果像不像本人?能保留情绪吗? 答:课件帮声音复刻采用深度学习模型,能提取音高、音调、节奏等特征,音色相似度很高。同时支持多情绪切换(如开心、悲伤、激昂),特别适合语文朗诵、历史故事等需要情感表达的微课场景。
问:上传音频后需要等待多久? 答:上传30秒音频后,通常几十秒内即可生成声音模型,随后就能在TTS界面使用。整个过程不超过几分钟,比传统配音效率提升80%以上。