声音不好听不敢录微课?课件帮声音复刻一键克隆你的专属音色
01 先聊个扎心的事:你有多久没给自己的微课配音了?
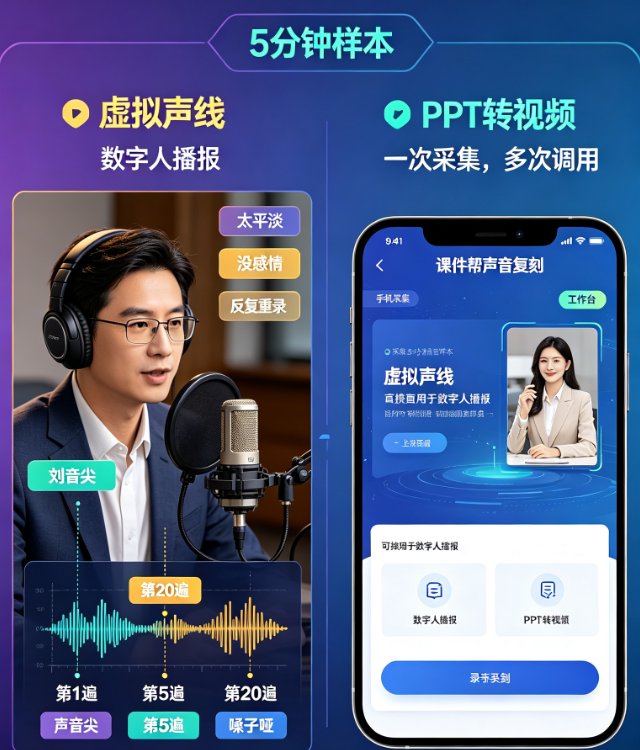
上周和一个做考研辅导的刘老师吃饭,她跟我倒苦水:“课件做得挺好的,学生反馈也好,但我就是不敢录旁白。一听自己的录音就浑身难受,觉得声音又尖又平淡,像个没感情的朗读机器。”
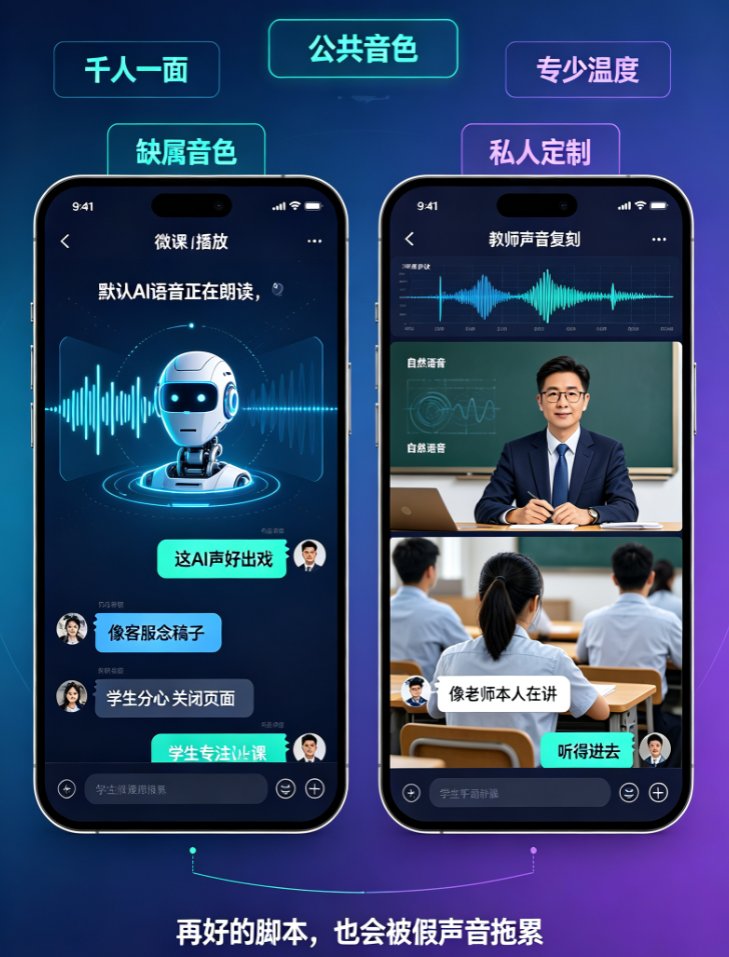
说实在话,这话我听了不止一次。很多老师做微课,PPT、教案、习题都能搞定,唯独卡在“配音”这一步,一拖就是几周。更有甚者,直接放弃自己录音,用网上找的AI机器音,结果学生一听就说“这课好冷,没人味儿”。
别急着否定自己, 你以为的“声音不好听”,在别人耳朵里其实没那么糟。但问题在于:你自己不自信,就会反复重录,一节课录二十遍,嗓子哑了,时间也没了。
要解决这个问题,核心不是让你练声,而是用工具帮你绕开“反复录制”。课件帮的声音复刻功能,就是干这个的。
02 声音复刻到底怎么回事?一句话讲明白
说白了,声音复刻就是让AI学会你的说话方式,然后替你干活。你只需要提供一小段自己说话的录音,AI就能提取你的音色、语调、停顿习惯,生成一个和你高度相似的“虚拟声线”。
整个操作不需要任何技术背景,你只需要一个安静的环境和一部手机,或者电脑。
课件帮的声音复刻流程就四步,我帮你拆开看:
| 步骤 | 操作 | 耗时 | 说明 |
|---|---|---|---|
| 第1步 | 打开课件帮官网,进入“声音复刻”功能 | 1分钟 | 无需下载软件,浏览器直接操作 |
| 第2步 | 用手机或电脑麦克风录制5分钟语音样本 | 5分钟 | 内容随意,自然朗读即可,像平时说话一样 |
| 第3步 | 提交录音,等待AI分析克隆 | 10分钟 | 后台自动训练,期间你可以做其他事 |
| 第4步 | 在数字人播报或PPT转视频中选用克隆声音 | 1分钟 | 直接调用,像选字体一样简单 |
别踩这个坑:录音时背景噪音要尽量小,不要有回音。如果条件允许,用手机自带的耳机麦克风效果更好。
03 “声音不好听”是心理枷锁,不是技术问题
刘老师后来告诉我,她试了课件帮后,录完样本就去做别的事了。十分钟后回来,用克隆声音把之前那个“卡壳”的PPT转了视频,播放出来,她愣住了:“这声音好像是我,但怎么比我自己录的还舒服?”
原因很简单:AI在克隆时,自动去掉了你录音时的紧张感、换气声和轻微口误,留下的是你最自然、最稳定的状态。
这就是声音复刻的价值——它不是把你变成一个别人,而是把你“最好的声音状态”固定下来。之后你输入任何文字,都能用这个声音念出来,语气、停顿、口音习惯都在,但不需要你一遍遍重录。
偷偷告诉你:课件帮的声音复刻,相似度能到95%以上。日常教学场景里,学生几乎分辨不出区别。你听自己的克隆声音,会觉得“这是我,但我没那么紧张”。
04 真实案例:5分钟录音,批量生产精品微课
说个更实在的例子。去年,一家做职业资格培训的机构遇到一个难题。负责《经济法》的王老师教了15年,学生通过率一直很高,但退休后,接手的新老师讲了半年,通过率掉了一截。校长急得不行,甚至想过花高价请王老师回来录课,但王老师身体不好,没法长时间出镜。
后来,他们用课件帮的「声音复刻」功能,只花了5分钟录音,就克隆了王老师的声音,再结合数字人播报,批量生成了整套微课。新老师只需要用王老师的声音模板,配合课件帮的PPT转视频功能,就能持续产出和王老师风格一致的课程。
来看效果对比:
| 对比项 | 传统方式(聘请新老师重录+剪辑) | 课件帮方案(声音复刻+数字人微课) |
|---|---|---|
| 录音成本 | 新老师录制全套课程,需3-5天,费用约1万元 | 王老师5分钟录音,免费复刻,后续使用零成本 |
| 视频制作周期 | 每节课拍摄+剪辑约2天,总时长30天 | 每节课PPT转视频+数字人合成约1小时,总时长2天 |
| 课程质量一致性 | 新老师风格不同,学生反馈不适应 | 风格完全一致,学生几乎无感知 |
| 后期维护成本 | 新老师离职或变动,课程需重新录制 | 声音模板永久可用,可无限复用 |
数据来源:该机构内部实测,制作成本降低约80%,效率提升约90%。
划重点:声音复刻不是用来替代真人,而是用来放大真人的价值。让那些有经验、有口碑的老教师,即使退休了,也能继续用他们的声音影响更多学生。
05 组合拳:声音复刻 + 数字人 + PPT转视频 = 全链路降本增效
如果说声音复刻是“保留灵魂”,那数字人播报就是“赋予身体”,PPT转视频则是“快速成型”。三件套组合起来,就是一套完整的微课生产流水线。
课件帮的「声音复刻」不是孤立功能,它和数字人、PPT转视频、智能排版等能力深度打通。你克隆完声音后,可以直接在同一个项目里选数字人形象、调整口播稿、合成视频。不需要切换工具,不用导出导入。
举个例子:你想把一份20页的Word教案做成数字人微课。在课件帮里,导入Word文档,智能排版自动生成PPT,选一个数字人形象,调用你已经克隆好的声音,一键合成视频。总耗时不到1小时,而传统方式至少要3天。
如果你是刚接触这个功能,建议从数字人微课个性化趋势:声音复刻+形象定制这篇文章看起,里面有更详细的形象定制方案。也可以看看声音不像自己?课件帮声音复刻三步让AI用你的音色讲课,手把手教你操作。
常见问题
Q: 声音复刻需要多少语音样本?
A: 课件帮声音复刻仅需录制5分钟左右的中文语音样本,内容可以是任意自然朗读,不需要特定脚本。录音环境安静即可,手机或电脑麦克风均可。
Q: 复刻后的声音和原声差别大吗?
A: 课件帮采用深度学习模型,复刻后的声音在音色、语调、停顿习惯上与原声相似度超过95%。日常教学场景下,学生几乎分辨不出区别。
Q: 声音复刻后能用在哪些地方?
A: 复刻后的声音可直接用于数字人播报、PPT转视频旁白、知识科普视频配音等。支持多语速、多情绪调整,适配不同教学场景。
Q: 声音复刻功能是否支持多人同时使用?
A: 支持。课件帮团队版支持多账号协作,每个账号可独立录制和克隆声音,方便多个讲师同时使用。