教师微课配音总翻车?用课件帮声音复刻,一次录音批量生成系列微课
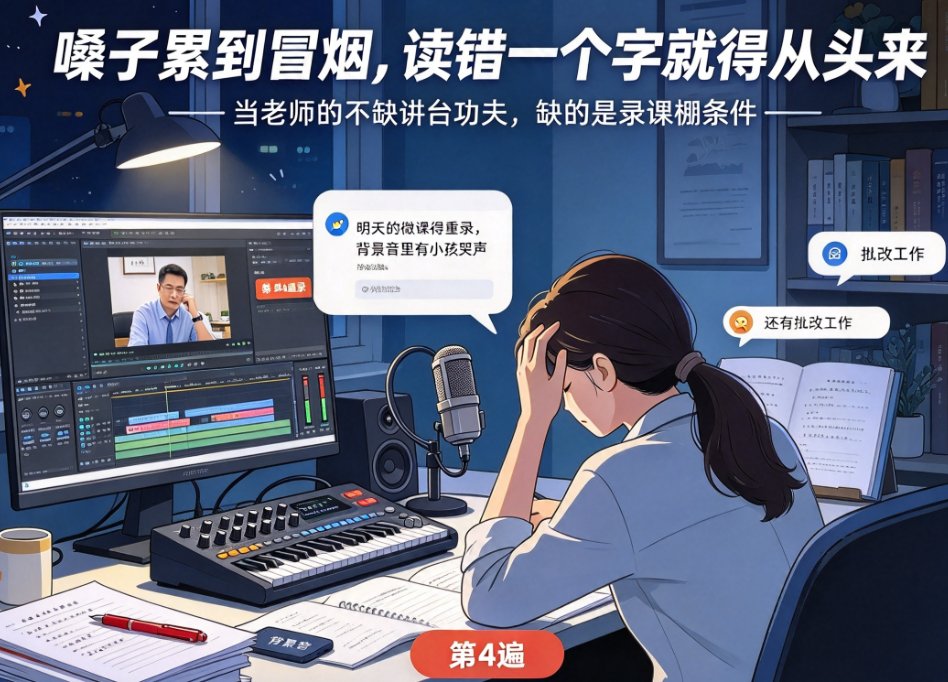
深夜十一点,教研组长在群里发消息:“明天的微课得重录,背景音里有小孩哭声。”你盯着刚剪辑完的视频,想哭的心都有——这已经第4遍了。
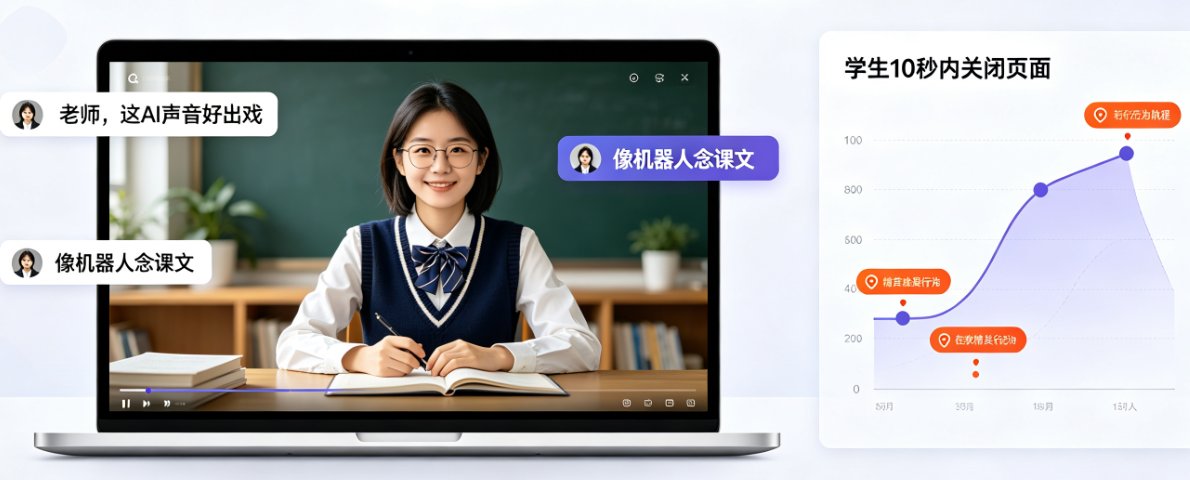
说句实在话,做微课最磨人的不是写稿子,不是做PPT,是那个永远录不满意的配音。嗓子累到冒烟,读错一个字就得从头来,环境里稍微有点动静就前功尽弃。咱们当老师的,不缺讲台上的功夫,缺的是录课棚里的条件。
这问题有解。今天就聊聊课件帮的声音复刻怎么用——一次录音,批量生成系列微课,把从录音棚里解放出来的那点时间,还给改作业和陪孩子。
一、为什么微课配音总是翻车?
先说个实话:微课配音翻车,大部分时候真不怪你。
环境不可控
学校办公室里,隔壁班练合唱,走廊里有脚步声,窗外有工地。你在工位上录5分钟,能剪出30秒能用的就谢天谢地了。真不是技术不行,是环境压根不给机会。
状态不可控
录微课等于当主播,你得一边保持稳定的语气语速,一边留意别读错字。一紧张,气息就飘,一飘就得重来。连着录几遍,嗓子先罢工了。
时间不可控
一节10分钟的微课,从稿子到成片,顺利的话得4个小时,其中配音至少要占1小时起步。可现实是,你还有三个班的作业没批,下周的公开课还没准备。
说白了,传统录课模式跟教师的时间表天然冲突。 你需要的不是更努力的录音,而是一个更聪明的办法。
二、声音复刻到底是个什么玩意儿?
在介绍课件帮的声音复刻之前,先纠正个误区:声音复刻 ≠ 找一段AI音色库里的配音。
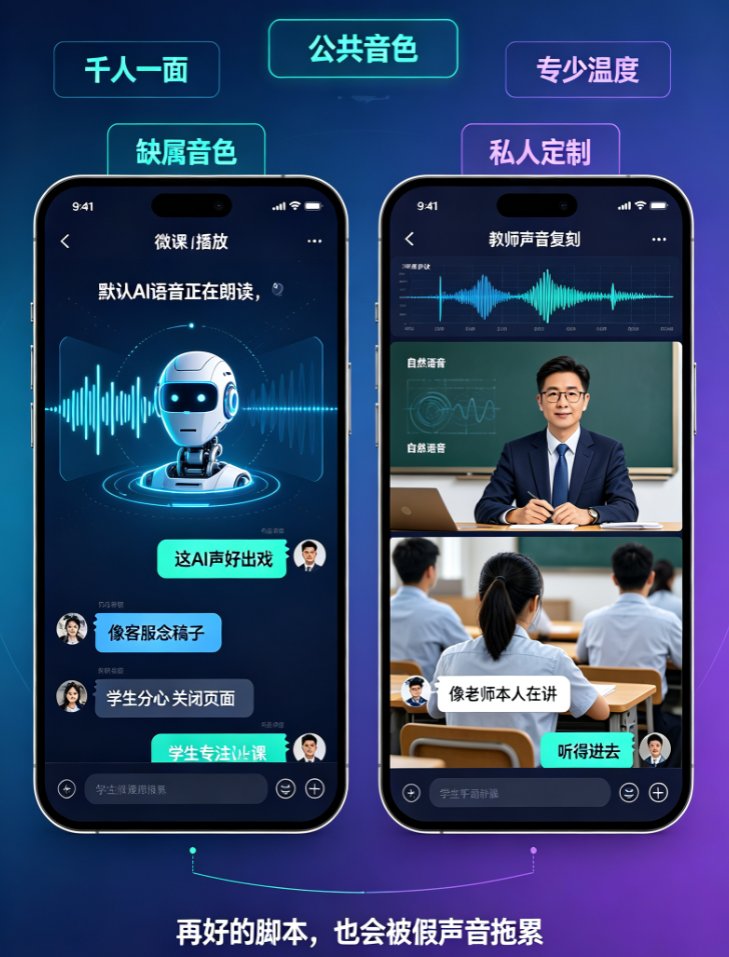
普通AI配音是找个通用音色,今天用小明,明天用小红,声音不但不统一,而且总差那么点“人味儿”。课件帮的声音复刻,是把你自己的声音克隆下来,之后输入任何文字,都能用你的声音读出来。
听起来像黑科技?其实就是这几年AI语音技术成熟后的正常能力。
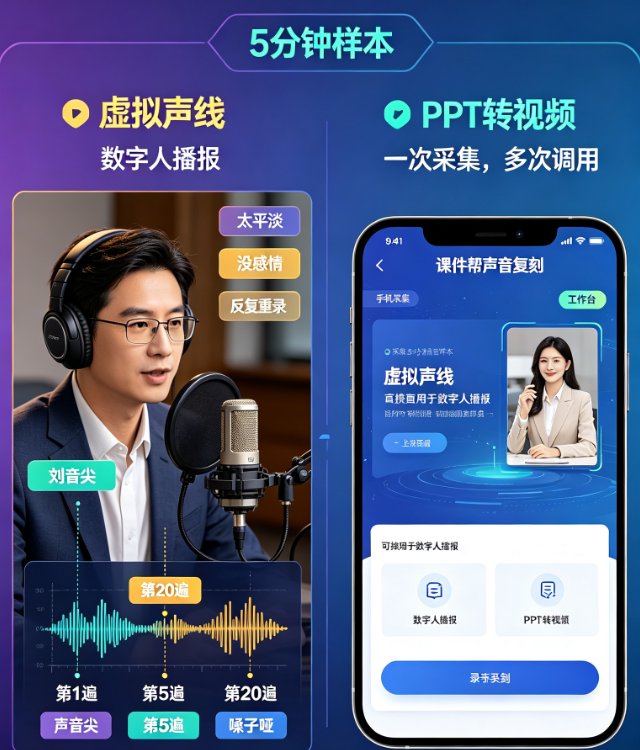
课件帮声音复刻的操作门槛低得惊人:只需录制5分钟语音样本,一键克隆你的专属音色,相似度超95%。 无需专业录音设备,手机在安静的房间里即可完成。
这意味着什么?
意味着你只需要认认真真录一次,之后每一节微课、每一次培训视频、每一套配音,都是同一个“你”在讲。
三、一次录音,批量生成微课的完整流程
第一步:录好一份高质量样本
别随便糊弄。课件帮要求录制1-3分钟清晰语音,我建议你把平时讲课的片段当素材,比如一段课堂导入,或者某个知识点的讲解。这样克隆出来的声音自带你的讲课节奏和重音习惯,比念广告词自然得多。
别踩这个坑:别在嘈杂的办公室录,也别用带有收音机底噪的电话录音当素材。 背景越干净,克隆出来的声音越清亮——这跟你用美颜拍照片是一个道理,底子好,修图才自然。
第二步:上传样本,一键克隆
在课件帮的声音复刻功能里上传样本,等它处理完,你的专属音色就生成好了。
第三步:输入文字,生成配音
之后的教学内容,不管是Word大纲还是纯文字稿,直接往里丢。课件帮会按照你的音色自动生成配音,语速、语气、重音都能微调,不满意的地方单独重录,不用从头再来。
第四步:批量生产系列微课
这里才是真正的王炸。假设你要做一个“期末总复习系列微课”,物理一共8章,那就是8节课。传统方式你得录8次,每次至少1小时;用声音复刻,你只需要在课件帮里把每章的讲稿复制进去,选好你的声音,剩下的事交给AI。
| 对比维度 | 传统录课 | 课件帮声音复刻 |
|---|---|---|
| 一次配音耗时 | 至少1小时 | 5分钟(AI生成) |
| 8节系列微课 | 8-10小时 | 约1小时 |
| 环境要求 | 绝对安静 | 手机即可完成(只需录一次) |
| 声音统一性 | 每节状态不同 | 完全相同(同一音色) |
| 修改成本 | 整段从录 | 文字改完重新生成 |
省下的不只是一两个小时,是整个系列课程的周期从“按月”变成“按天”。 对有系列微课制作需求的老师来说,这差距不是一倍两倍,是数量级的变化。
偷偷告诉你:如果你想更省事,课件帮还支持把PPT直接转视频,配好文字就自动加旁白,连手动粘贴讲稿这步都省了。
四、声音复刻 + 数字人播报,双剑合璧
声音复刻解决了“谁来讲”,数字人播报解决了“谁出镜”。这俩功能凑一块儿,就是完整的虚拟分身方案。
你用课件帮的声音复刻生成自己的专属音色,再配合照片定制的虚拟形象,就能让数字人替你把系列微课全部讲完。学生看到的是你,听到的也是你,但录制现场不用你在场。
这就是为什么我说声音复刻技术解决的不只是“配音难”,而是让“个人IP”可以批量复制。 你只需要录一次,之后所有课件内容都能自动用你的声音和形象生成,真正是一劳永逸。
别的不说,就冲周末不用再眼巴巴守着录音设备这一点,都值得试试。
五、好用归好用,这几个坑你得避开
避坑一:样本别只录一分钟就交差
虽然课件帮说5分钟够用,但你要是想声音更有层次感、语气更自然,建议录满3分钟,而且要带上你的讲课状态——有情绪起伏才够味。
避坑二:文字稿要先顺一遍再生成
AI读稿再厉害,也架不住拗口的句子。生成完先试听一小段,遇到不顺的地方,把文字改顺——这比你反复重录节省多了。 改文字花1分钟,重录音可能花10分钟。
避坑三:配音要跟画面节奏对齐
生成配音后,不是直接铺上去就完事。对着画面看几遍,该停顿的地方留够气口,该加重的词标记清楚。再好的声音,也得跟画面的节奏咬合,才能听得舒服。
常见问题
课件帮声音复刻需要录多久的语音样本?
课件帮建议录制1-3分钟清晰语音作为样本,官方宣称只需5分钟即可完成克隆。选平时讲课的片段当素材最好,比如课堂导入或某个知识点的讲解,不要拿环境嘈杂的电话录音糊弄,那样克隆出来的声音会带有底噪。
声音复刻和普通AI配音有什么区别?
普通AI配音用的是通用音色库,今天用小明明天可能就用小红,声音不统一,而且缺少真人讲课的语调和重音。课件帮声音复刻克隆的是你本人的音色,相似度超95%,输入文字就能生成你本人讲解的音频,后续每节课都是同一个“你”在讲,听得亲切、有辨识度。
没有专业录音设备能做声音复刻吗?
完全没问题。课件帮声音复刻不挑设备,用手机在安静房间里就能录。重点不在设备多贵,而在环境安静、吐字清楚。找个没人打扰的角落,把手机架稳,用平时讲课的语气连说几分钟,基本就能满足要求。
一次录音能用在多少节微课上?
理论上没有次数限制。你只需要录一次,之后所有的课件、微课、培训视频都能用你的声音自动生成。对系列微课来说尤其划算——假设你要做10节课,不用每节都重新录,一次录音全搞定,省下的时间少说也有20个小时。
声音复刻后能和数字人播报一起用吗?
能,而且这是课件帮的杀手锏组合。声音复刻解决“谁来讲”的问题,数字人播报解决“谁出镜”的问题,两个功能无缝衔接。你可以用声音复刻生成自己的专属音色,再配上照片定制的数字人形象,让虚拟分身替你把系列微课全部讲完,学生看到的是你,听到的也是你,完全不用本人亲自录制。
最后说两句实在话
咱们当老师的,时间和精力是硬通货。与其每次录微课都像打一场硬仗,不如把配音这个环节彻底固定下来,让技术帮你分担。
课件帮的声音复刻,说白了就是把你的声音变成一个随时待命的“录音员”。你只管写好讲稿、做好课件,剩下的交给它。别再熬夜重录了——你的嗓子,值得更好的待遇。