声音复刻成本高?课件帮AI声音克隆几步搞定,老师也能拥有专属配音
深夜十一点,李老师坐在书桌前,对着麦克风念第 5 遍讲稿。前 4 遍要么多音字读错,要么咳嗽打断,要么语气平淡得像念经。她看了一眼时间,叹了口气——明天上午就要交微课视频,而 30 页 PPT 的配音才录了一半。
这不是虚构场景。我认识的不少老师,做微课最耗时的不是备课,而是配音。外包配音贵、通用 AI 音色没辨识度、自己录音又费时……这些痛点几乎人人踩过。但说句实在话,2026 年了,这事儿早该交给 AI 了。
今天咱们聊的,就是课件帮声音复刻——用几分钟语音样本,克隆出你自己的声音,让 AI 替你念讲稿。配合 PPT 转视频 功能,一键就能生成带专属配音的微课。
01 为什么微课需要“你的声音”?
先想一个问题:学生看微课时,听到的是标准播音腔,还是你熟悉的声音,哪个更容易投入?
答案不言而喻。声音是教师个人品牌的一部分,就像板书笔迹一样有辨识度。 学生听到你的声音,会自然联想到课堂氛围,学习代入感更强。这也是为什么很多老师宁可花几小时录音,也不愿用通用 TTS 音色。
但传统录音的代价太高了:
- 耗时长:30 分钟微课,录音+校对至少 2-3 小时;
- 成本高:外包配音每分钟 50-200 元,一节微课可能花掉几百块;
- 一致性差:状态不好就破音、卡壳,重录是家常便饭;
- 个性化弱:通用 AI 音色千篇一律,学生记不住。
声音复刻的价值,就是把“录音”从体力活变成技术活。 你只需要录一次样本,之后所有讲稿都能用你的声音自动生成。
02 声音复刻怎么用?课件帮实操三步走
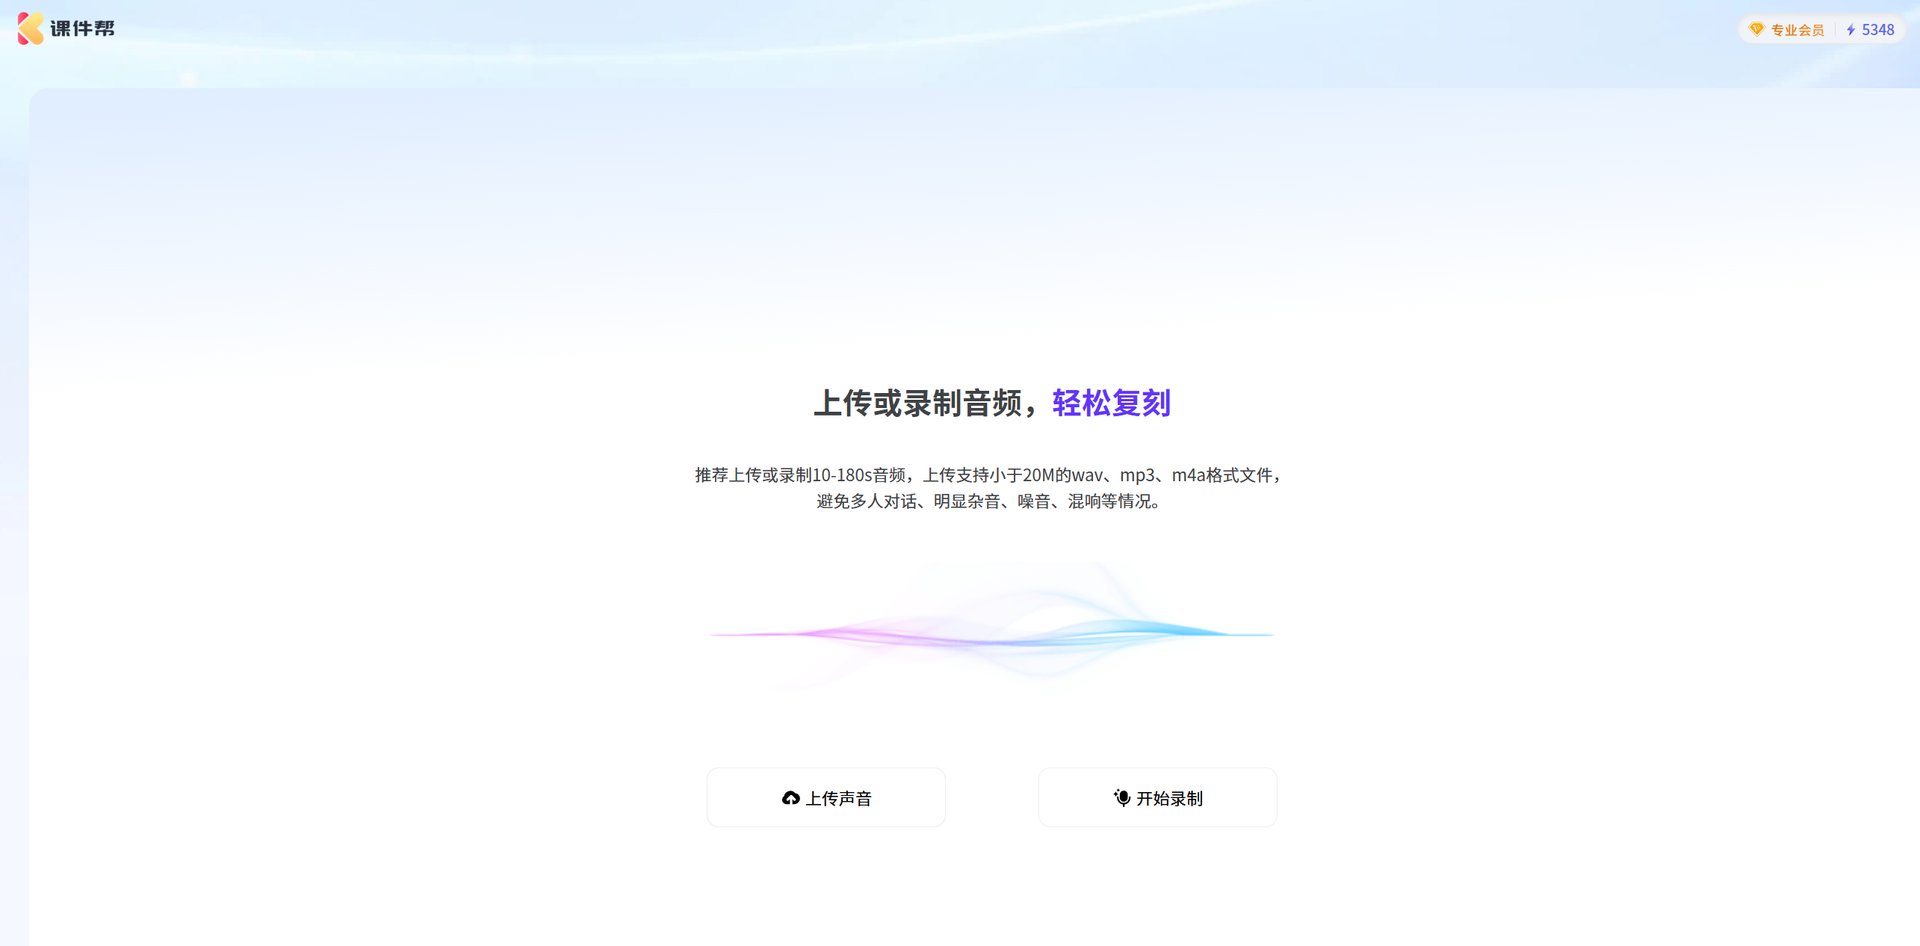
第一步:录制语音样本
打开课件帮的声音复刻功能,按提示录制一段 3-10 分钟的朗读音频。内容可以是你的讲课稿、课文片段,或者系统提供的参考文本。
别踩这个坑:别在嘈杂环境录,也别用变声器或美声效果。AI 需要提取的是你的原始声纹特征,越干净越好。手机自带录音机在安静房间里录,效果就够用。
第二步:等待模型训练
上传样本后,系统会自动提取声纹特征,生成专属声音模型。这个过程通常几分钟到十几分钟,取决于样本长度和服务器负载。
第三步:生成配音或数字人视频
训练完成后,你可以在两个场景中使用:
- 纯配音:把讲稿粘贴到课件帮,选择你的克隆声音,直接生成 MP3 配音,再导入 PPT 转视频 功能,一键合成微课;
- 数字人播报:在数字人播报中选择你的专属形象,配上克隆声音,生成有真人温度的口播视频。
说白了就是:录一次,用无数次。 之后每次更新课件,只需要改文字,声音自动生成,再也不用对着麦克风反复念稿。
03 传统录音 vs 声音复刻:成本与效率对比
说句实在话,没有对比就没有说服力。我整理了一份常见场景的对比数据:
| 对比维度 | 传统逐页录音 | 外包配音 | 课件帮声音复刻 |
|---|---|---|---|
| 30 分钟微课配音耗时 | 2-3 小时 | 1-2 天(含沟通) | 30-40 分钟 |
| 成本 | 录音设备+时间 | 每分钟 50-200 元 | 平台订阅费 |
| 声音一致性 | 易受状态影响 | 稳定但无个性 | 稳定且保留个人特色 |
| 多音字处理 | 需人工校对 | 需反复沟通 | AI 自动识别 |
| 更新课件配音 | 需重新录制 | 需重新付费 | 改文字即可 |
| 学生代入感 | 强但效率低 | 弱 | 强且高效 |
从数据看,声音复刻在效率上提升 3-5 倍,在成本上降低 90% 以上。 对需要批量制作微课的老师或培训师来说,这个差距是决定性的。
以下是一个 30 分钟微课配音成本对比图:
04 声音克隆的进阶玩法:数字人+个人音色
如果你以为声音复刻只能做配音,那就小看它了。声音复刻和数字人结合,才是微课制作的完全体。
课件帮的数字人播报功能,支持上传照片或视频生成专属虚拟形象,再配上你的克隆声音,就能生成一段“真人感”口播视频。整个过程不需要摄像机、不需要灯光、不需要出镜。
偷偷告诉你:我见过一位历史老师,用课件帮做了个“虚拟自己”讲古代战争,学生反馈说“比看纪录片还有代入感”。因为声音是老师本人的,学生听着亲切,注意力自然集中。
这种组合特别适合:
- 微课升级:把现有 PPT 转成带讲师数字人的视频,提升观感;
- 翻转课堂:把知识点录成 5 分钟短视频,供学生课前预习;
- 教师 IP 打造:用统一形象+声音输出系列内容,建立个人品牌。
声音复刻不是替代教师,而是让教师从重复劳动中解放出来。 省下的时间,可以用来设计互动、打磨教学设计,这才是 AI 该干的事。
05 安全与合规:克隆声音会不会被滥用?
说到声音克隆,很多人第一反应是“会不会被拿去诈骗”。这个担心合理,但课件帮在安全层面做了几件事:
数据安全是声音复刻大规模落地的前提。 如果你所在学校对数据安全有严格要求,可以看看课件帮的私有化部署方案。
别踩这个坑:别用公共平台的免费声音克隆工具处理学生信息或敏感内容。教育场景的数据合规,比省那点钱重要得多。
06 声音复刻适合谁?
不是所有人都需要声音克隆,但下面这几类人,用了会真香:
- 微课制作频繁的老师:每学期要交 20 节以上微课,时间就是命;
- 录制环境不佳的老师:宿舍、教室有噪音,录音效果差;
- 方言口音重的老师:AI 能帮你“标准”但不失个人特色;
- 培训师/知识付费创作者:需要批量产出视频内容,且要有辨识度。
说白了,只要你有“用声音输出内容”的需求,声音复刻就值得一试。成本不高,但省下的时间和提升的一致性,是实打实的。
如果你想试试,可以从课件帮的微课制作入门,先用AI 做课件把 PPT 准备好,再用声音复刻+PPT 转视频走完整个流程。
常见问题
课件帮声音复刻需要多少语音样本?
通常录制 3 到 10 分钟的清晰朗读音频即可。课件帮会提取声纹特征生成专属音色,样本越长、环境越安静,克隆效果越自然。建议在安静房间用手机或电脑麦克风录制,避免背景噪音和回声。
声音复刻和普通 TTS 配音有什么区别?
普通 TTS(文本转语音)用的是通用音色,所有用户听起来都差不多;声音复刻则是克隆你自己的声音,保留个人音色、语调和节奏,让微课有辨识度。对教师来说,学生听到的是熟悉的声音,学习代入感更强。
用克隆声音做微课会不会有安全风险?
课件帮支持私有化部署和本地化处理,声音样本和生成的音频文件可存储在校内服务器,数据不出校。同时平台提供使用授权和溯源机制,防止声音被滥用。建议教师只用于教学场景,并妥善保管账号权限。
声音复刻能用于数字人播报吗?
能。课件帮支持将克隆声音与数字人形象组合,生成有真人感的口播视频。你可以在数字人播报中选择形象,再选择克隆音色,一键成片。适合微课、企业培训、知识科普等多种场景。