教师录课不想重复录音?课件帮声音复刻+数字人播报实战指南
你花的几十个小时,最后毁在「机器声」上
你辛辛苦苦备了一周课,用AI生成了数字人形象,结果点开播放——
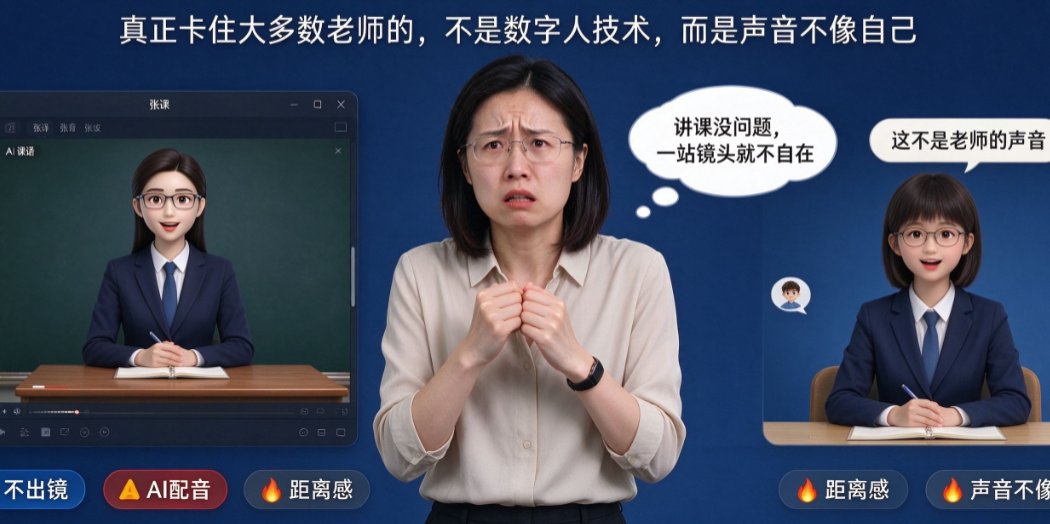
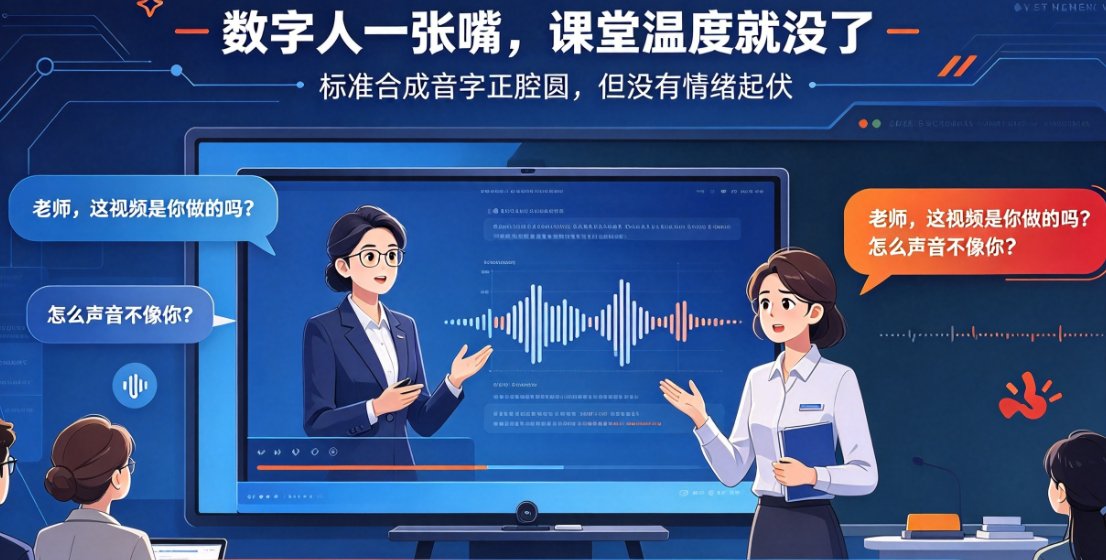
声音干巴巴、没有起伏、每个字都像从同一个模子倒出来的。 学生看了直摇头:「老师,这声音听着好假,不想听了。」
这是很多老师、培训师在做数字人视频时最头疼的环节。形象可以定制,口型可以对齐,但一听声音就露馅了。
说白了,数字人播报的「灵魂」是声音。声音不自然,再好的内容也像隔着毛玻璃,缺乏信任感。
01 传统数字人音库的三大硬伤
市面上大多数数字人工具用的是通用语音合成库,哪怕号称「多音色」,本质上还是机器拼凑。
| 对比维度 | 传统合成音库 | 课件帮声音复刻 |
|---|---|---|
| 声音来源 | 预设的通用音色库 | 克隆用户的真实嗓音 |
| 自然度 | 机械感强,语调平 | 保留个人语速、重音、停顿习惯 |
| 情感表达 | 基本无法调节情绪 | 支持调节喜悦、严肃、柔和等情感 |
| 个性化 | 千人一面,无法区分 | 每个账号独一无二,无人能复制 |
| 录制成本 | 无需录制,但效果差 | 仅需30秒样本,一次录制永久使用 |
传统方案的核心问题:它不关心「你是谁」。 它只关心「这个音色听起来像真人」,但永远不是你。
别踩这个坑:用通用音库生成微课,学生听着听着就走神了——因为那不是「你」在讲课。
02 声音复刻:让数字人「活」起来
课件帮的声音复刻功能,彻底解决了「数字人说话像机器人」的尴尬。
你只需要录制30秒左右的语音样本(朗读一段预设文本),系统就会自动学习你的声音特征——包括语速、停顿、抑扬顿挫、甚至轻微的方言口音。
生成后的声音,就是你的「数字分身」。 用它来播报课程、配音视频,学生听到的第一反应是:「老师,你声音怎么和本人一样?」
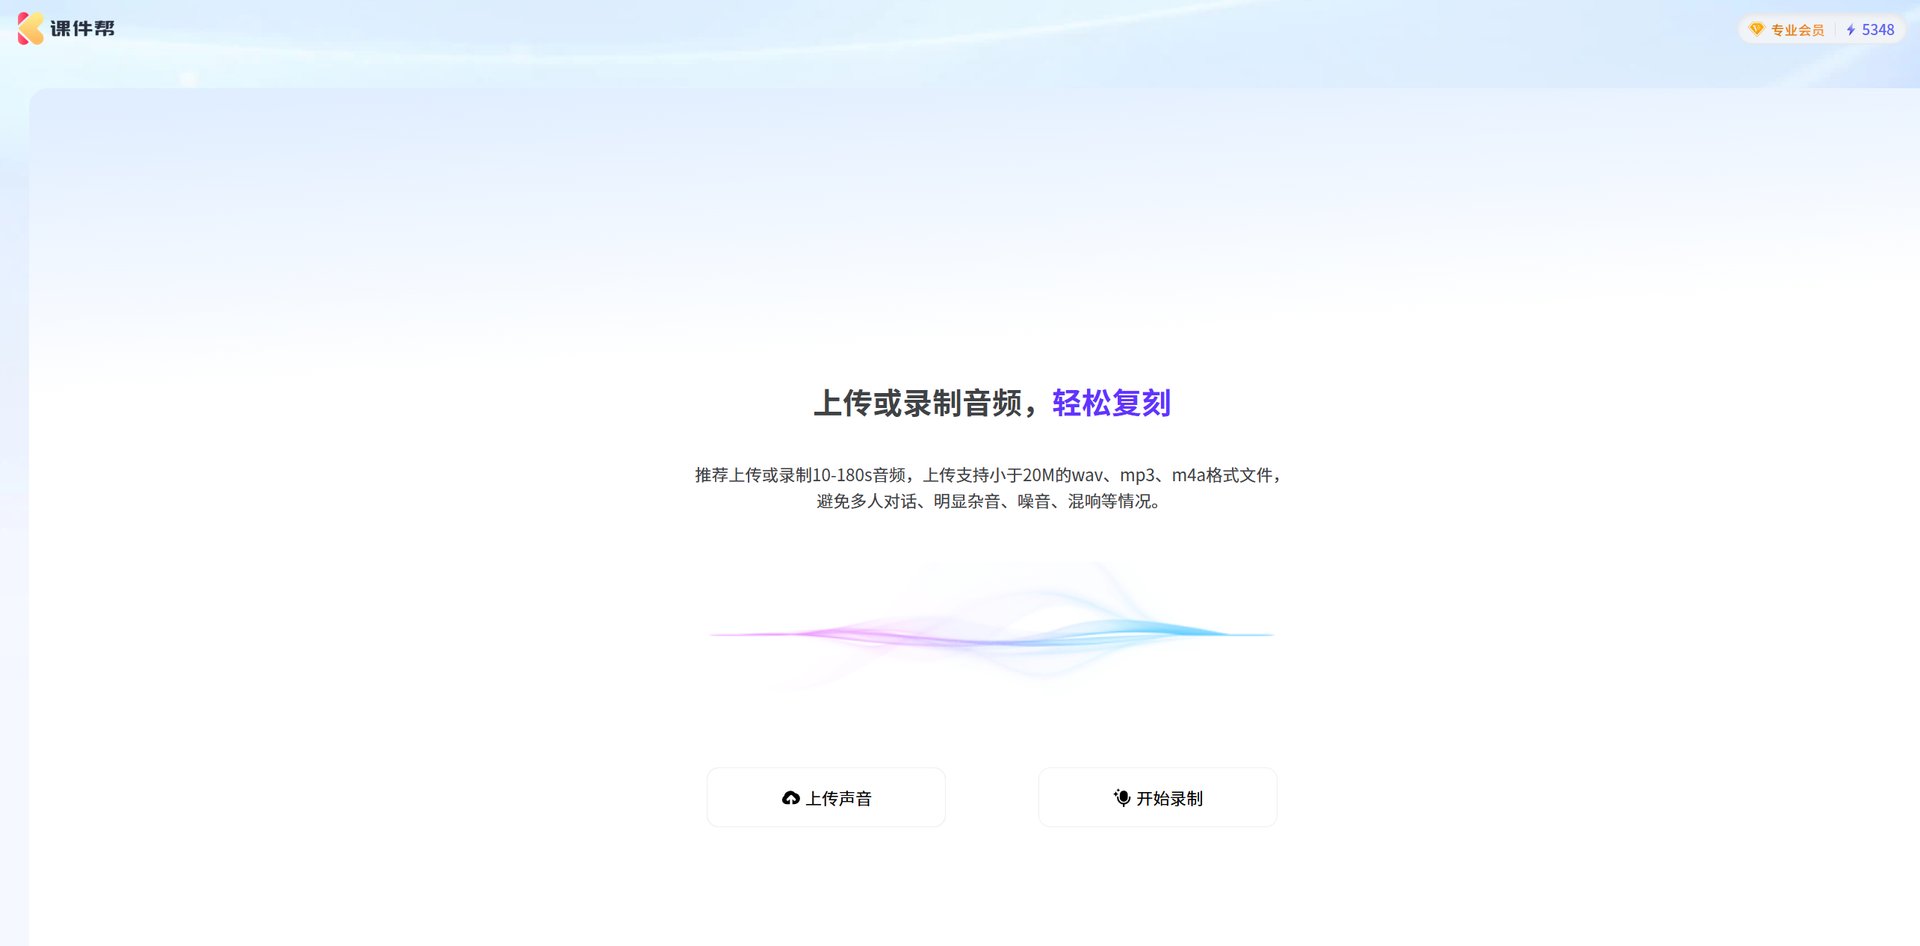
我们之前写过一篇关于声音复刻完整操作流程的文章,包括录制技巧和注意事项,点这里看:数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课。
03 5步完成声音复刻,从零到专属数字人
课件帮把声音复刻做成了「傻瓜式」操作,任何老师、培训师都能在10分钟内搞定。
第一步:进入声音复刻入口
登录课件帮(kejian365.com),进入「数字人」模块,选择「声音复刻」。
第二步:录制30秒样本
按照提示朗读一段文本,内容涵盖不同声调、音节的组合。建议读两遍,选最自然的一次。
别踩这个坑:录样本时别用手机免提、别在嘈杂环境。安静+近麦=最好的克隆效果。 用耳机麦克风,保持正常说话音量,效果直接翻倍。
第三步:等待模型训练
系统自动处理,一般1-3分钟即可完成。你的声音模型就生成了,保存在个人账号中。
第四步:选择数字人,绑定声音
新建一个数字人播报项目,在「声音」设置里选择你克隆的声音。可以调整语速、音量、情感语调。
第五步:生成视频,预览效果
输入文字内容,一键生成视频。播放时,你会惊讶于声音的相似度——连换气、停顿的小习惯都还原了。
偷偷告诉你:如果你有多个课程需要不同声音,可以创建多个复刻模型。比如数学课用你的声音,历史课用同事的声音,轻松切换。
04 声音复刻的更深层价值:信任与情感连接
声音复刻不仅仅是「让声音像真人」,更核心的是建立信任感。
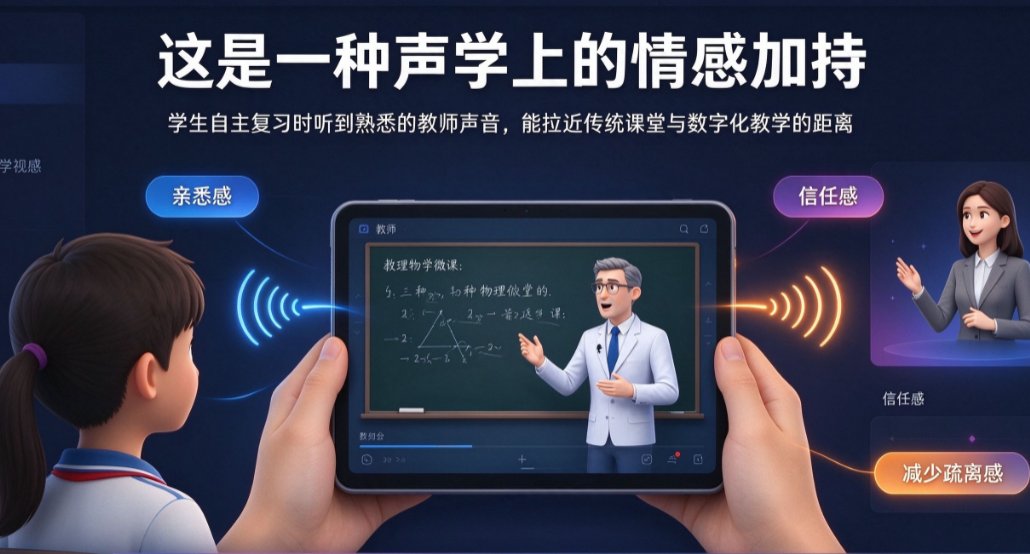
学生听课,尤其是微课、培训视频,声音的亲和力直接影响学习效果。一个熟悉的声音能让人放松、专注;而机械声则让人本能地排斥。
课件帮还支持情感语调调节:你可以让数字人用「严肃」语气讲重点,用「柔和」语气讲案例,甚至加入「幽默」元素。声音不再是平板一块,而是有情绪、有温度的「人」。
这一点在数学、物理这类逻辑性强的学科中尤其重要——用严肃语调强调公式推导,用轻松语气带过复习环节,课堂节奏感立刻就有了。
如果你还在用通用音库做数字人微课,可以看看我们对比蝉镜的那篇文章:2026数字人播报趋势解读:课件帮AI为何比蝉镜更懂教学场景?。
05 声音复刻+数字人 = 你的专属内容工作室
课件帮声音复刻的核心思路很简单:把「你」复制进数字世界里。
说白了,声音复刻让你从「创作者」升级为「导演」——你只需要写好脚本,剩下的一切交给课件帮。
具体流程可以这样理解:
- 写脚本:用课件帮AI生成PPT大纲或直接粘贴文本。
- 选数字人:从模板库挑一个形象,或用照片定制专属虚拟讲师。
- 绑定声音:用你克隆好的声音模型驱动数字人。
- 一键成片:自动生成字幕、配乐、转场,输出为视频。
这套流程下来,你不再需要反复录音。录一次声音样本,后面所有视频都用同一个「你」来播报,内容还能批量产出,成本比传统录制降低80%不止。
想了解批量拍摄成本对比,可以看这篇:培训预算只够做1条视频?课件帮AI数字人批量制作,成本骤降80%。
如果你也想做属于自己的数字人IP,那这篇关于声音复刻与形象定制结合的文章值得一看:2026数字人IP化趋势:课件帮如何用声音复刻与形象定制打造专属教学助手?。
常见问题
声音复刻需要录制多久的样本?
课件帮声音复刻仅需录制30秒左右的语音样本,朗读一段预设文本即可。样本越清晰、背景噪音越少,克隆效果越好。建议使用安静环境、近麦克风录制。
复刻后的声音可以用于哪些场景?
复刻后的声音可直接用于课件帮数字人播报,生成口播视频;也可作为视频配音,为PPT转视频、知识科普视频等添加旁白。支持多语种和情感语调调节。
声音复刻的隐私安全如何保障?
课件帮采用加密存储和传输,用户声音数据仅用于本人授权项目,不会外泄或用于训练其他模型。支持私有化部署的机构可进一步确保数据本地化,符合学校数据安全要求。
能否同时使用多个声音?
可以。课件帮支持创建多个声音复刻模型,每个模型对应一个真人声音。您可以根据课程内容或角色切换,比如数学课用老师声音,历史课用专家声音。
声音复刻效果是否真实?
课件帮声音复刻基于深度学习模型,能捕捉语速、停顿、重音等个人特征,生成的声音与真人相似度极高。配合数字人形象,能极大提升视频的沉浸感和信任度。
如果你还在为重复录音发愁,不妨试试课件帮——30秒采样,10分钟出片,让你的数字人真正「像你」在说话。
打开微信扫一扫
分享到朋友圈或好友