数字人只会用系统音色?课件帮声音复刻让AI用你的声音讲课
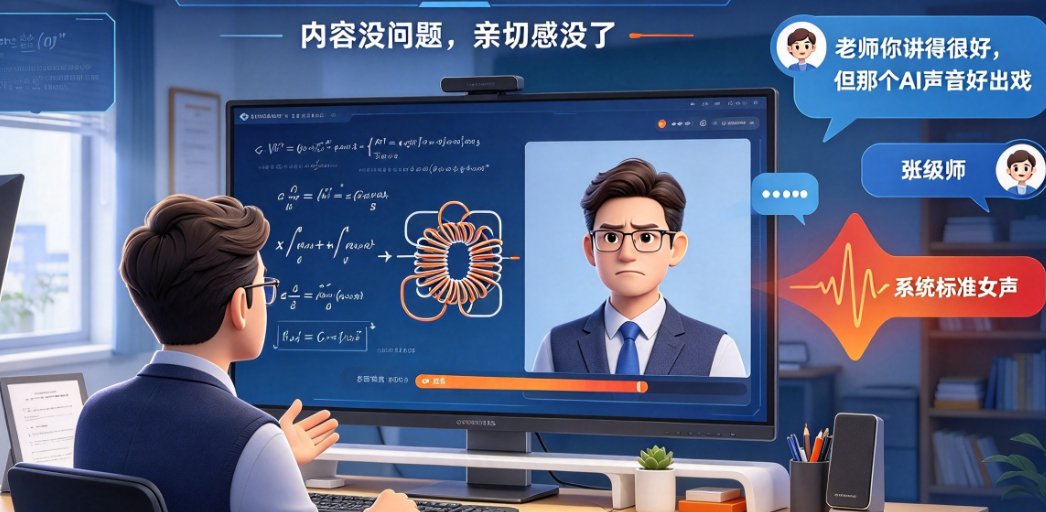
先讲个真事。昨天一位教初中物理的张老师找我吐槽:学校这学期要求每位老师把重点章节做成微课,挂到校本资源平台上供学生回看。她课件做得挺利索,唯独配音这关过不去——试过市面上的TTS,音色是够播报,但一张嘴就是“AI味”,别说学生听着出戏,她自己听了都直皱眉头。
后来她听了同事的建议,用声音复刻试了试,把自己普通话带点方言尾音的嗓音录了小十分钟,生成后让数字人用她的声音讲了一段自由落体。她发语音跟我说:“天,连我讲到重点时那个微微上扬的尾音都保留下来了,学生看到肯定说是我本人,以为我录了好几小时。”
这个故事里藏着很多老师都在经历的隐性焦虑:不是不愿意做微课,而是不想出镜,也不想用冷冰冰的标准AI音色来上课。声音,是个人辨识度最高的东西之一,科技再普及,也替代不了“这是我老师的原声”带来的亲切感。
今天这篇不堆参数,就聊聊课件帮的声音复刻功能,它是怎么用几分钟的录音,让数字人用你的声音替你讲课的,以及你在实操时应该注意什么。
一、先弄清楚:声音复刻解决的到底什么问题?
不少老师分不清“文本转语音”和“声音复刻”的差别。咱们打个比方:
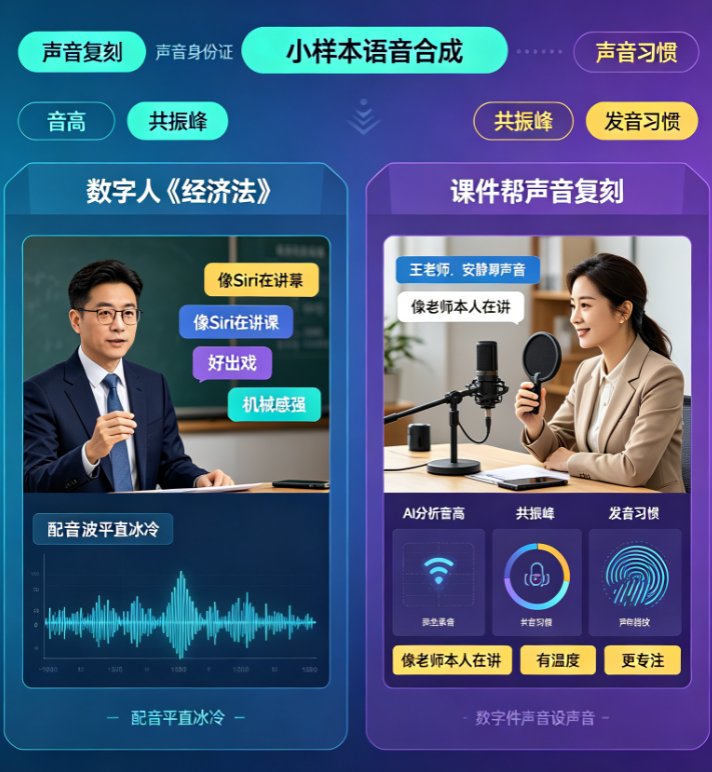
- 预设音色(TTS):相当于你从一堆现成声线里挑一个来读稿,声音好听,但与你无关。
- 声音复刻:像给你的声音拍了一张“声纹照片”,基于它做训练,生成专属声音模型。你讲什么,AI就能用你的语气、你的节奏、你独特的发音习惯说出来。
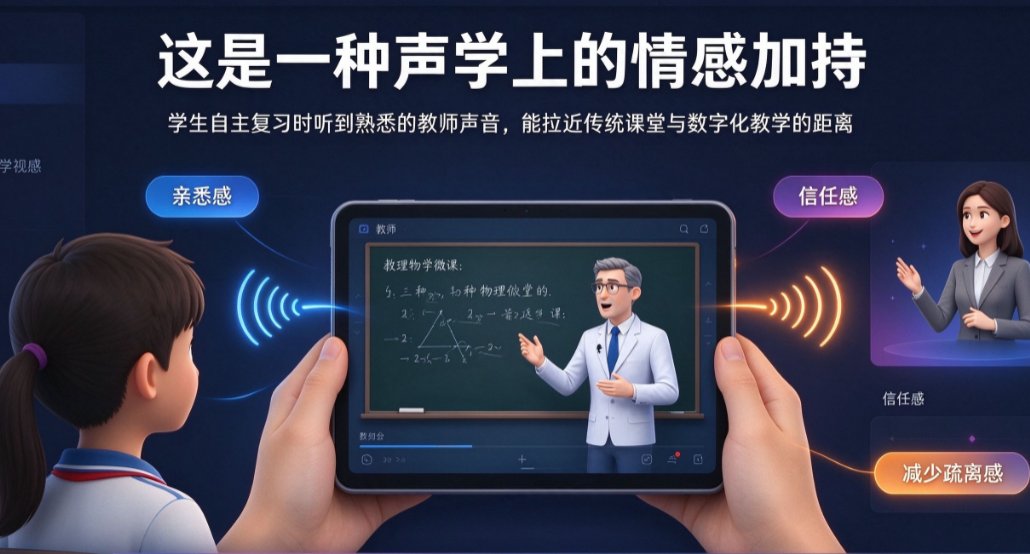
说句实在话,对教师群体来说,后者带来的体验感是颠覆性的。课程面向的是你的学生,他们对什么最敏感?当然是你开口第一句话的那个音色和语调。用你克隆出来的声音讲课,学生听到的是“熟悉的老师”,而不是“完美的播音员”。这种熟悉感,能最大限度消解录播课的疏离感。
有研究也提到,教师在数字化教学中结合声音复刻技术,学生在自主复习时能听到熟悉的教师声音,可以拉近传统与数字化教学的距离——本质上,这是一种“声学上的情感加持”。
别踩这个坑: 不要拿预设音色硬顶个人微课。除非你完全不在意“AI感”,不然学生在第一秒就会出戏。而一旦学生出戏,这个微课的观看完成率和信任感就大打折扣了。
二、实操拆解:用课件帮声音复刻,三步生成专属AI配音
课件帮的声音复刻流程,说白了非常简单,甚至比录一段语音还轻松。你只需要三步:
第一步:准备与录制
直接录5分钟左右的样本就行。环境安静,手机或电脑麦克风即可。别追求录音棚效果,重点是声音清楚。建议提前备一段300~500字的稿子,内容别干巴巴念课文,最好能模拟你平时讲课的语气,有提问、有强调、有停顿,这样克隆出来的声音在讲微课时更自然。
第二步:训练与生成
把录音文件上传到课件帮,系统就会基于样本训练出专属声音模型。这个过程不需要你懂任何技术,等待几十秒到几分钟,你的“声纹分身”就建好了。
第三步:套用到数字人或PPT转视频流程
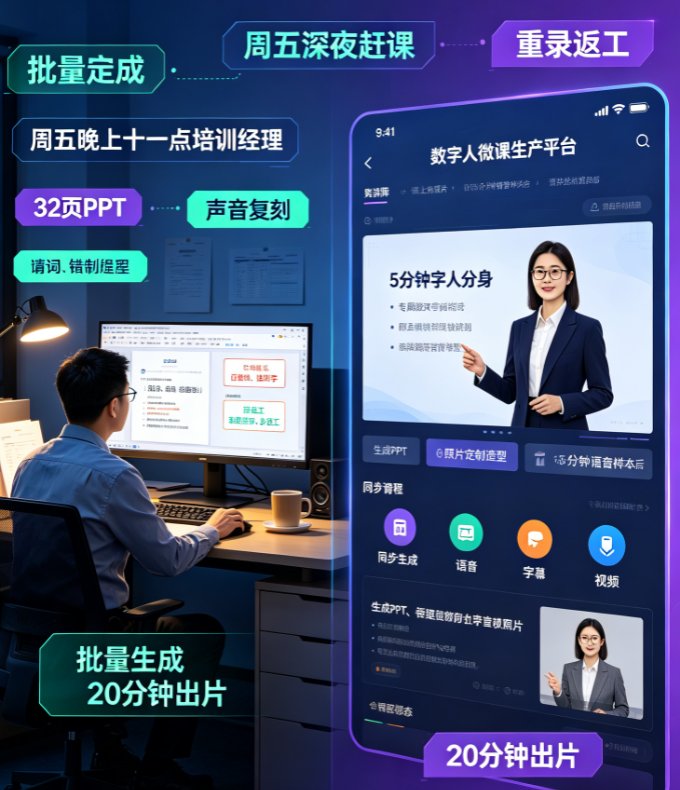
这就是真正的效率点。在课件帮里做数字人微课时,直接从音色列表里选中你克隆好的声音;做PPT转视频时,同样可以指定用你的克隆音色来朗读每一页的讲解词。
整个流程走下来,有的老师第一次就成功导出了10分钟的微课视频,声音是他本人的,形象是数字人的,他全程没开过一次镜头。
三、几个直观对比,帮你快速做决定
| 对比维度 | 系统预设音色 | 课件帮声音复刻 |
|---|---|---|
| 音色来源 | 平台预置 | 你自己的录音 |
| 个性化程度 | 低,人人可用 | 高,专属声纹 |
| 学生感知 | 一秒识别AI | 像真人原声 |
| 耗时成本 | 选完就用,零耗时 | 录5分钟+训练几分钟 |
| 长期价值 | 无记忆点 | 沉淀个人IP |
说穿了,系统音色是“借来的嗓子”,声音复刻才是“自己的嗓子”。 对想建立个人品牌、想让学生记住“这个声音就是我的老师”的内容创作者来说,这个差异是决定性的。
如果你还在纠结画面和形象问题,别担心——课件帮的照片定制数字人功能,配合声音复刻,能把你的形象和声音一并“虚拟化”。想了解数字人形象怎么选,可以看看这篇关于数字人照片定制的攻略。
四、教师和培训师,怎么把声音复刻用到极致?
声音复刻的价值不止“做微课”。对教师和培训师来说,几个典型场景你值得试试:
场景1:历史课件批量“重新配音”
把过去几年的旧课件导入课件帮PPT转视频,选你的克隆音色,一键生成带讲解的复习视频。学生回看时听到熟悉的讲解声,比看冷冰冰的文字课件强太多。
场景2:多门课程音色统一
一个老师可能教几个班、几门课。用同一个声音模型,所有课程的数字人微课音色一致,学生一听就知道是“你的课”。这正是个人辨识度累积的开始。
场景3:企业培训的口播视频
培训师不必每次出镜录制,用数字人+声音复刻就能批量产出口播课程。声音是自己的,内容是专业的,效率还上来了。想了解数字人在企业培训里怎么规模化,可以看看这篇数字人播报成本分析。
五、避坑指南:三个关键注意点
以下是实操中高频出现的坑,提前给你排掉:
1. 录音别追求“完美播报”
偷偷告诉你: 录稿子时稍微带点停顿和语气起伏,效果会更好。平铺直叙地念,AI学到的就是“念稿”的声音,而不是“讲课”的声音。带着平时上课的节奏去录,复刻出来的声音才像“人话”。
2. 关注算力与导出
不同平台的导出模型和会员规则差异很大。课件帮新用户注册会赠送500算力点,约可生成10分钟视频,足够体验完整个流程再决定是否升级。
3. 素材版权意识
虽然你用克隆声音生成的内容在多数平台可用于教学,但如果是第三方商业项目,建议预留授权证明,避免后续争议。
六、声音复刻+数字人,就是你的“专属AI讲师”
声音是你自己的“一张名片”。不是在录音棚里才能体现专业性,在安静的办公室、用手机自带录音功能,录5分钟讲稿,你的声音分身就已经开始运作了。
课件帮把声音复刻、数字人播报、PPT转视频这些能力串联起来,其实是想解决一个更根本的问题:让没有设计或视频制作基础的人,也能快速产出专业级教学与培训内容。 你不需要懂技术,只要提供自己的声音和内容,剩下的交给AI。
如果你想深入了解数字人如何规模化生产微课,或者想对比不同数字人工具的差异,这有篇文章可以参考:数字人微课制作工具对比。
常见问题
问:声音复刻和普通AI配音有什么区别?
答:普通AI配音只能从预设音色中选择,声音好听但与你无关。声音复刻基于你的录音样本训练专属声音模型,保留你的音色、语调、停顿习惯甚至微上扬的尾音,相当于你的声音分身。
问:声音复刻需要录多久的样本?
答:课件帮声音复刻只需录制5分钟左右的有效语音样本,建议在安静环境用手机或电脑自带麦克风。准备一段300~500字的讲稿,模拟你平时讲课的语气,效果更佳。
问:声音复刻可以用于PPT转视频吗?
答:可以。课件帮PPT转视频功能支持导入PPT后自动提取逐页文案,同时选择已克隆的个人声音作为解说音色,生成讲解视频时由数字人用你的声音播讲。
问:数字人微课用声音复刻和直接用系统音色,学生体验差别大吗?
答:差别很实际。系统音色再流畅,学生仍能一秒识别非真人,替代感强。而用你自己声音克隆的数字人,学生听到熟悉的音色、熟悉的节奏,更容易进入状态,课堂代入感完全不同。
问:声音复刻的音频可以商用或用在校级公开课吗?
答:建议在使用前确认平台的授权范围。课件帮支持导出音视频用于常规教学场景,但若涉及大规模商用或公开出版,建议联系官方确认具体授权条款。