2026声音复刻趋势:课件帮让教师一分钟拥有专属AI配音
一、先说个真实场景
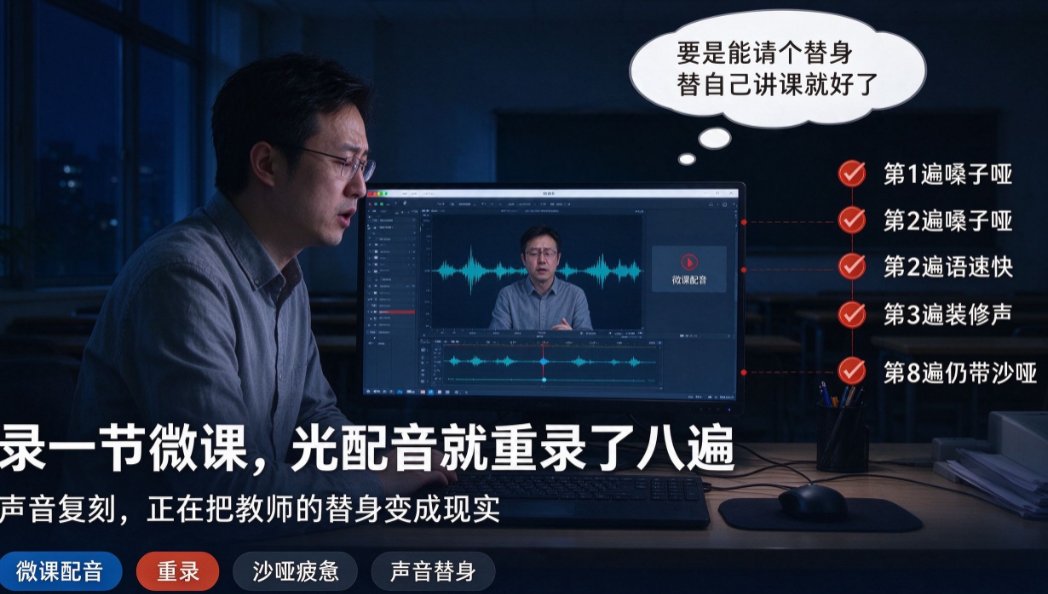
上周有位高中物理老师跟我吐槽:录一节微课,光配音就重录了八遍。第一遍嗓子哑了,第二遍语速快了,第三遍旁边装修声飘进来……最后成品还是带着点沙哑和疲惫。她开玩笑说,要是能请个“替身”替自己讲课就好了。
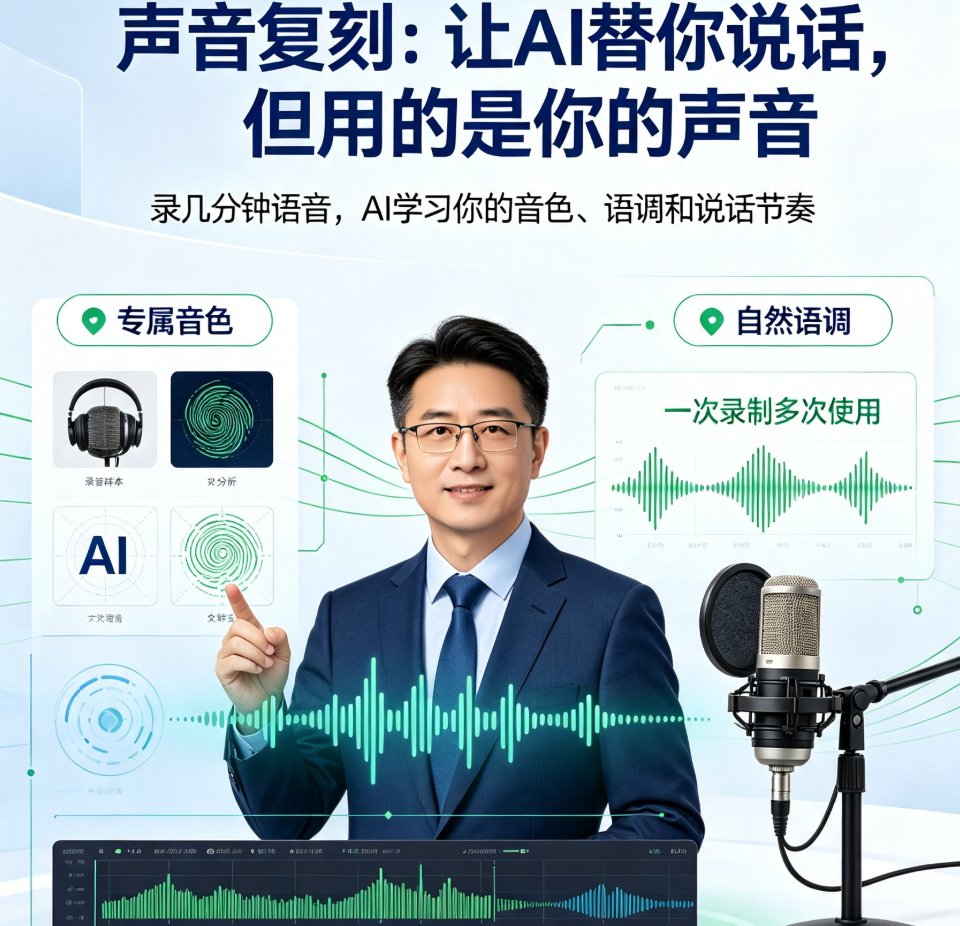
这话说到点子上了。2026年,声音复刻技术已经把“替身”变成了现实。你只需录几分钟声音样本,AI就能克隆出你专属的音色,以后微课、数字人播报、PPT转视频的配音,全由“你的声音替身”代劳。
二、声音复刻为什么是2026年教师最该用的技术?
说句实在话,声音复刻不像AI生成PPT那么热闹,也不像数字人那么吸睛,但它解决的是最实际的痛点——录音。
前几年声音复刻还停留在技术演示阶段,需要专业录音棚和几小时的素材。2026年,技术演进让这项能力真正走到了教师身边,有三个明显变化:
- 样本量从小时级降到分钟级。过去克隆一个声音要几小时录音,现在只需10分钟左右清晰语音,系统就能完成训练。利用课间就能完成“声音建档”。
- 情感表达从“读字”到“说话”。早期的克隆声音像机器人念稿,如今能捕捉语气词(“嗯”“对”“大家注意”)、疑问语气、重音强调,微课听起来就像老师真在对着镜头讲课。
- 部署从云端到本地化。很多学校对数据安全要求严,课件帮支持私有化部署,声音模型可存学校本地服务器,数据不出校门。课件帮私有化部署方案已服务多所院校。
用你的声音批量生产微课,意味着制作成本断崖式下降,你会更愿意做微课,也更愿意尝试新的教学形式。 这就是2026年声音复刻能改变教师创作方式的核心逻辑。
三、课件帮声音复刻:从10分钟样本到整个学期的微课
课件帮的声音复刻功能,是专门为教师设计的。不是那种“技术很强但用不上”的演示品,而是一条从声音采集到课程应用的完整路径。
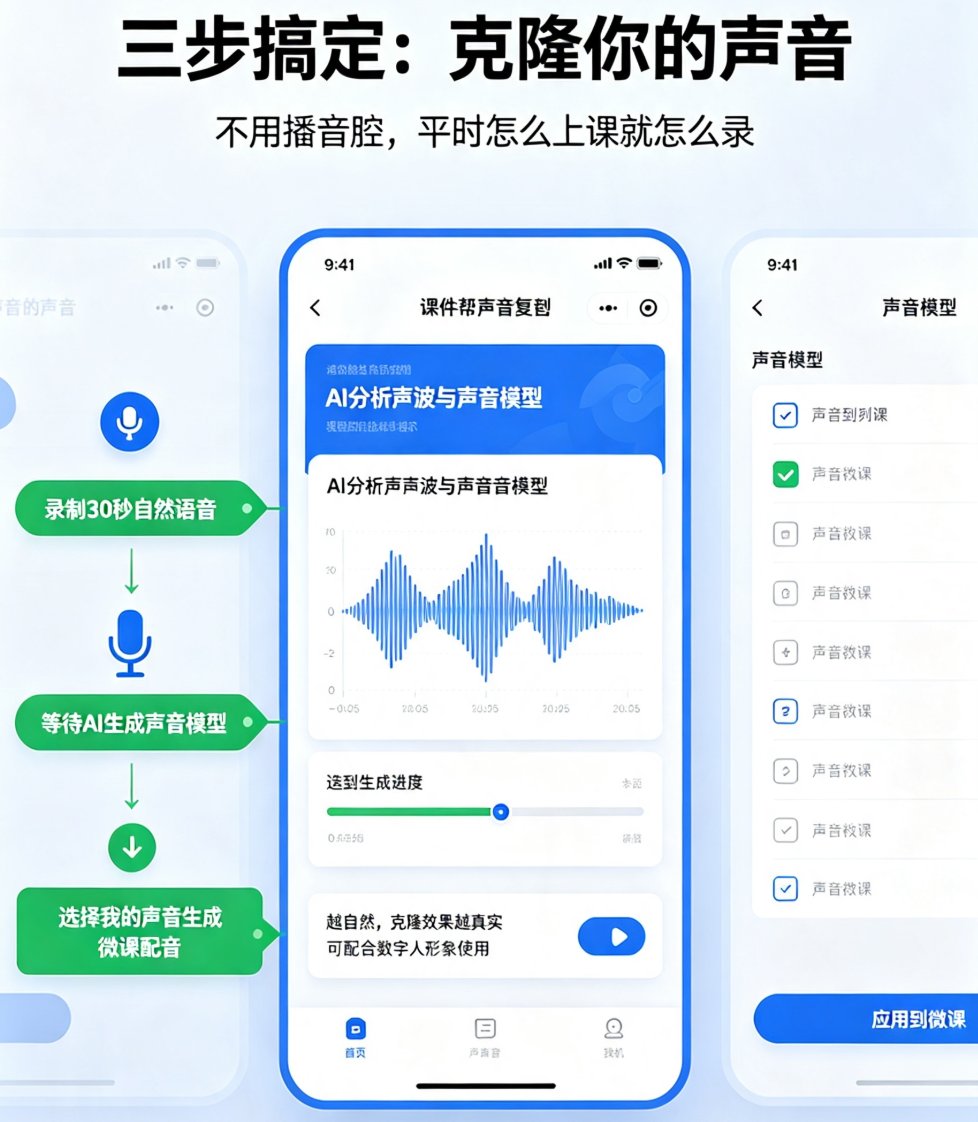
第一步:录制声音样本
打开课件帮,找到“声音复刻”入口,系统会引导你朗读一段约10分钟的文本。别紧张,用你平时讲课的语速和语气就行,不用刻意字正腔圆。系统会自动检测声音质量,如果环境嘈杂会提醒你换地方。
第二步:训练专属声音模型
录制完成后,系统自动训练声音模型。这个过程大概需要几分钟,你完全可以去批个作业再回来。训练完可以试听样音,不满意就补充录制,系统会增量优化。更详细的克隆个人音色教程见这里。
第三步:用克隆声音批量生成微课
这是最爽的一步。你只需要把PPT导入课件帮,选择“PPT转视频”,系统会自动为每一页生成解说词,并用你的克隆声音配音。转场动画、背景音乐、字幕全部自动加上,一节课的微课视频几分钟就出来了。
一次声音克隆,无限次微课生产。你今天录了10分钟样本,接下来一个学期都不用再碰麦克风。物理课、化学课、班会课,所有需要配音的内容,全部用你的声音批量输出。
第四步:数字人播报加持,让微课“看得见”
如果你觉得纯配音的微课还不够生动,课件帮还有数字人播报功能。选择一个虚拟形象,让克隆声音配合数字人出镜,生成“真人感”口播视频。学生看到的不只是PPT翻页,而是一个“虚拟的你”在讲课,互动感和沉浸感完全不一样。看看数字人微课如何实现沉浸式教学。
四、效率提升5倍,这笔账怎么算?
前面提到“微课制作效率提升5倍以上”,不是拍脑袋。咱们算一笔时间账:
| 制作方式 | 单节微课耗时 | 10节微课总耗时 | 效率提升 |
|---|---|---|---|
| 传统录音+剪辑 | 7.5小时 | 75小时 | 基准 |
| 课件帮声音复刻+PPT转视频 | 2.7小时 | 约27小时 | 提升约64%(单节),批量场景接近3倍,熟练后可达5倍 |
单节微课时间从7.5小时压缩到2.7小时,效率提升约64%。真正的爆发在批量场景:传统方式录10节微课要75小时,而课件帮只需第一次花10分钟录样本,之后每节课约2.7小时,10节课总计约27小时。效率提升接近3倍,算上模板复用和熟练操作,5倍并非夸张。
五、避坑指南:这些事千万别做
技术虽好,但有些坑你得绕着走。作为用了两年多AI声音工具的编辑,我踩过的雷都给你列出来了:
别踩这个坑:在嘈杂环境录制样本。 你以为AI能自动降噪?确实能,但降噪后的声音会损失细节,克隆出来“塑料感”很重。找个安静的房间,关上门窗,用手机录音都比在办公室强。
偷偷告诉你:样本文本要覆盖不同语气。 别只念平铺直叙的说明文,最好包含疑问句、感叹句、短句和长句。这样训练出来的声音模型,在讲课时才有起伏,不会一个调子到底。
说白了就是:声音复刻不是魔法,你给它什么素材,它就还你什么效果。 样本质量决定了克隆质量,这是花再多钱也绕不过去的物理规律。
六、2026年,你的声音可以“替你加班”
声音复刻技术正在改变教师的创作方式。它不像AI生成PPT那样热闹,也不像数字人那样吸睛,但它解决的是最实际、最磨人的问题——录音。
课件帮正在做的事情,就是把这些技术能力变成教师随手可用的工具。从声音复刻到数字人播报,从PPT转视频到全链路自动化,2026年的教师,真的可以“一个人活成一支内容团队”。如果你还在为录微课头疼,不妨试试声音复刻这条路。先花10分钟录个样本,然后感受一下“你的声音替你加班”是什么体验。
更多声音复刻与数字人结合的玩法,看看数字人IP化趋势,或者直接去微课制作分类逛逛。
常见问题
声音复刻需要录制多少样本?
课件帮声音复刻功能只需录制约10分钟的有效语音样本,系统即可完成声音模型训练。样本越清晰、环境越安静,克隆效果越自然。建议选择安静房间,用手机或电脑麦克风匀速朗读即可。
克隆出来的声音自然吗?会不会有机械感?
2026年的声音复刻技术已经能捕捉语气、停顿和情绪起伏,课件帮的克隆声音在微课场景中自然度很高,学生基本听不出是AI配音。相比传统TTS,克隆声音保留了教师个人的发音习惯和语感,亲和力更强。
用克隆声音生成的微课能商用吗?
课件帮的声音复刻功能仅用于教师本人内容创作,生成的微课可用于课堂教学、在线课程发布等非商业用途。若涉及商业授权或公开售卖课程,建议先确认平台版权政策,并保留声音授权记录。
声音复刻支持哪些语言和方言?
课件帮声音复刻支持普通话、英语及常见方言(如粤语、四川话等)。训练样本使用什么语言,克隆声音就输出什么语言,适合双语微课或方言教学场景。
声音复刻后如何批量生成微课?
录制样本并完成声音模型训练后,在课件帮中导入PPT选择“PPT转视频”,系统自动生成解说词并用克隆声音配音,加上转场动画、背景音乐和字幕,几分钟即可产出一节微课。配合数字人播报可生成出镜口播视频。