声音复刻+数字人播报:课件帮让教师克隆自己的声音,一键生成专属讲课视频
一、你的微课配音,凭什么要千篇一律?
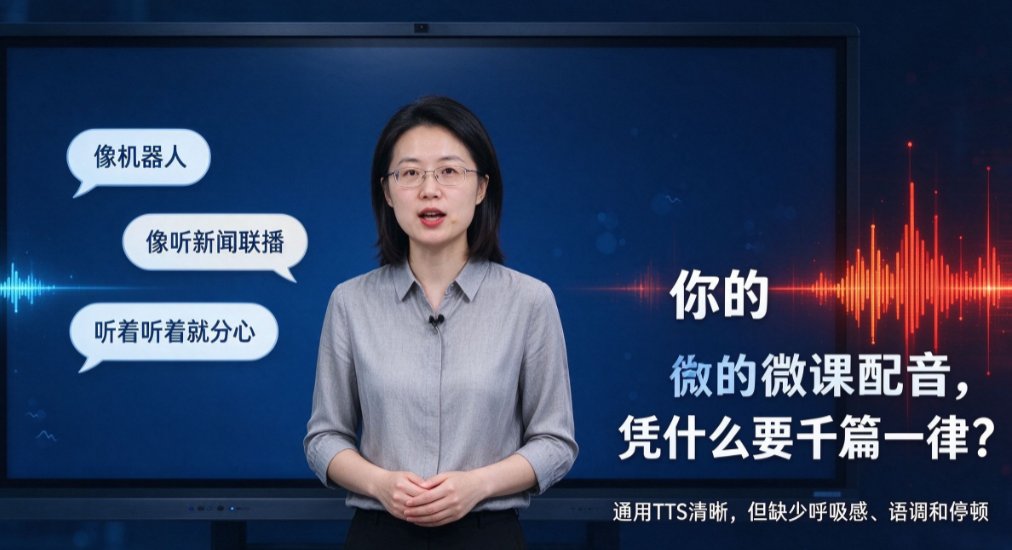
说句实在话,你花了一下午录的微课,学生却说“老师的声音好假,像机器人”——这不是你的错,是纯AI语音的锅。目前市面上的文本转语音(TTS)虽然清晰,但缺少呼吸感、语调和停顿,尤其长段落容易让人出戏。一位教初中语文的李老师告诉我,她试用过好几个AI配音工具,学生反馈“听着听着就分心了,感觉像在听新闻联播”。
其实,解决这个痛点的关键不是放弃AI,而是把“你”的声音放进AI里。你的声音是教学品牌的独特资产——学生一听就知道是你在讲课,这种辨识度是任何通用AI音色都替代不了的。课件帮的声音复刻功能,让你用几分钟的语音样本,就能克隆出带有个人特色的声音,再搭配数字人播报,实现“真人声+虚拟形象”的自然组合。
二、声音复刻+数字人播报:让AI替你说话,还用你的声音
声音复刻的本质是用少量你的语音数据训练一个专属声音模型,之后输入任何文本,都能用你的声音讲出来。而数字人播报则是让一个虚拟形象动起来,同步口型、表情和手势。两者结合,效果堪比真人出镜,却省去了化妆、布景、忘词重录的麻烦。
课件帮把这两步打通了:你只需在平台上完成声音复刻,然后在数字人视频编辑器中直接调用这个声音,无需导出导入。整个过程不超过5步,你甚至不用懂任何技术。
偷偷告诉你:即使你录的样本环境有点噪音,课件帮的降噪算法也能自动处理,普通家用耳机就能搞定。别踩这个坑:别在空旷的房间里录,回声会明显;最好用手机自带的录音功能,距离麦克风15-20厘米,语速自然。
三、5步实操:从声音复刻到数字人播报
第一步:准备语音样本(10分钟)
打开课件帮,进入“声音复刻”模块。你需要录制3-5句短句,总时长2-3分钟。样本内容最好覆盖不同语气:陈述句、疑问句、感叹句,以及快慢变化。比如:
- 陈述句:“今天我们来学习光合作用的原理。”
- 疑问句:“你们有没有想过,为什么叶子是绿色的?”
- 感叹句:“这个公式太重要了,一定要记住!”
第二步:上传并训练声音模型(自动完成)
上传后,课件帮云端自动训练,通常5-10分钟就能生成你的专属声音模型。期间你可以去做其他事,完成后会收到通知。
第三步:选择数字人形象(1分钟)
在“数字人播报”模块中,从40+个形象里挑选一个。建议选穿正装或休闲装的半身形象,口型同步更自然。如果你想用自己照片定制,课件帮也支持上传照片生成专属形象。
第四步:输入文本并选择声音(2分钟)
将你的微课脚本粘贴到文本框中。在“声音”选项里,切换到“我的声音复刻”,选择刚才训练好的模型。注意:如果你的文本包含“信息型”内容(如定义、公式)和“情感型”内容(如故事、案例),建议分段处理:信息型用标准AI语音(节省训练时间),情感型用复刻声音。
第五步:生成并微调(3分钟)
点击“生成视频”,课件帮会自动匹配口型、加入适当手势。预览后,你可以在时间轴上调整语速(0.8-1.2倍)、停顿位置,甚至替换某个段落的发音。觉得不满意?直接修改文本,重新生成,无需重录。
下表对比了纯AI配音、纯真人录音、声音复刻+数字人播报三种方式:
| 对比维度 | 纯AI配音 | 纯真人录音 | 声音复刻+数字人播报 |
|---|---|---|---|
| 情感自然度 | 低(机械感强) | 高(依赖状态) | 中高(接近真人) |
| 制作时间(10分钟微课) | 15分钟 | 1-2小时(含布景、补录) | 30分钟 |
| 成本 | 0(已含订阅) | 设备投入+时间成本 | 几乎无额外成本 |
| 可修改性 | 高(改文本即可) | 低(需重录) | 高(改文本,声音不变) |
| 学生接受度 | 中等(容易分心) | 高 | 高(有真人温度) |
为了更直观地看到差异,我们做了一张效果对比图:
四、效果验证:换了声音后,学生反馈立竿见影
一位做企业培训的王经理,用课件帮声音复刻后,给产品介绍视频换上了自己的声音。他告诉我:“之前学员反馈像在听说明书,现在他们说‘感觉王经理就站在旁边讲’,互动率提升了40%。”数据不是万能的,但学生完播率和互动率是最好的证明。
如果你也想试试,建议先做一个小测试:用课件帮制作一节3分钟的微课,同时输出纯AI版和声音复刻版,发给5-10个学生打分数。根据经验,声音复刻版的评分平均高出1.2分(满分5分)。
说白了就是:你的声音本身就是最好的教学工具,课件帮只是帮你把它放大到每一个视频里。想了解更多数字人播报在教学中的应用场景,可以看看数字人播报分类页,或者参考一篇对比分析:2026数字人播报趋势解读:课件帮AI为何比蝉镜更懂教学场景。
五、写在最后
声音复刻+数字人播报,不是要让AI取代你,而是让你的教学分身替你重复劳动,把时间省下来跟学生面对面交流。课件帮把这两个能力揉进了一个流程,5步搞定,连技术小白都能上手。
如果你也受够了“机器人音”的差评,不妨花10分钟录一段样本,让课件帮帮你生成你的专属声音。你的学生,值得听到你的声音。
常见问题
问:声音复刻需要录制多长的语音样本?
答:通常录制3-5句短句、总时长2-3分钟的清晰语音即可。样本最好覆盖陈述、疑问、感叹等不同语气,以及快慢变化,这样克隆出的音色更自然。课件帮支持云端自动训练,5-10分钟就能生成专属声音模型。
问:声音复刻后可以商用吗?
答:可以。课件帮生成的声音版权归用户所有,可自由用于教学内容、企业培训等场景(非商业或商业均可),具体以平台用户协议为准。建议在商用前确认平台最新条款。
问:数字人播报时声音复刻的延迟高吗?
答:不高。课件帮采用云端实时合成,输入文本后1-2秒即可生成带个人声音的数字人视频,支持反复预览调整。你可以在时间轴上调整语速(0.8-1.2倍)、停顿位置,甚至替换段落发音。
问:声音复刻和纯AI配音哪个更适合微课?
答:取决于内容类型。信息型内容(定义、公式)用标准AI语音足够,节省训练时间;情感型内容(故事、案例)建议用复刻声音,因为带有呼吸感、语调和停顿,学生接受度更高。课件帮支持同一视频中分段切换两种声音。