课件帮声音复刻教程:30秒音频克隆你的声音用于微课配音
课件帮声音复刻教程:30秒音频克隆你的声音用于微课配音
你有没有过这样的经历:辛苦做了一堂微课,配音却是冷冰冰的机器声,学生一听就出戏。想自己录吧,一紧张就磕巴,重录十几次还嫌声音不好听。其实,你不需要重新录——用30秒的普通录音,就能克隆出你的专属声音,让AI替你讲课。
这篇文章就手把手教你用课件帮的声音复刻功能,从录制素材到生成配音,全程不到10分钟。咱们不聊虚的,直接上实操。
01 为什么你该告别千篇一律的AI配音?
说句实在话,现在很多微课都用AI配音,但听起来总像同一个“播音员”在念稿。学生耳朵比咱们精明,一听就知道这课不是老师亲自讲的,亲和力直接打折。
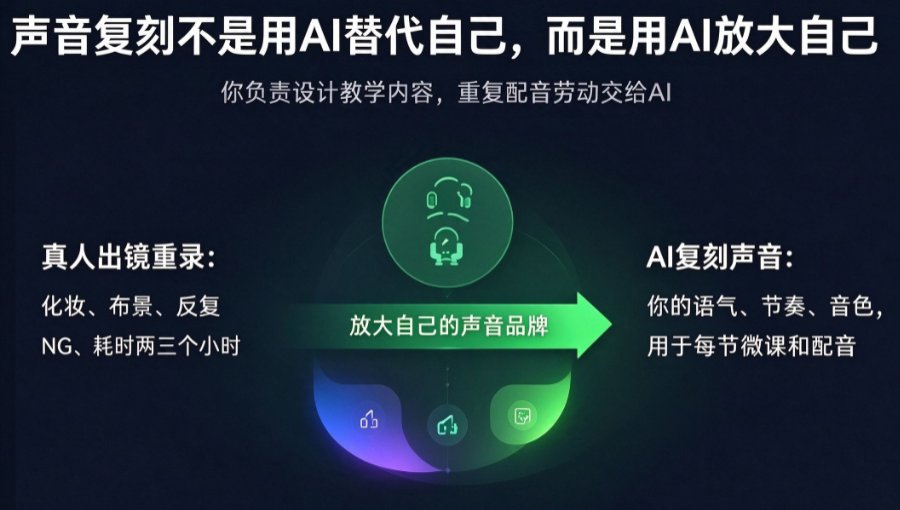
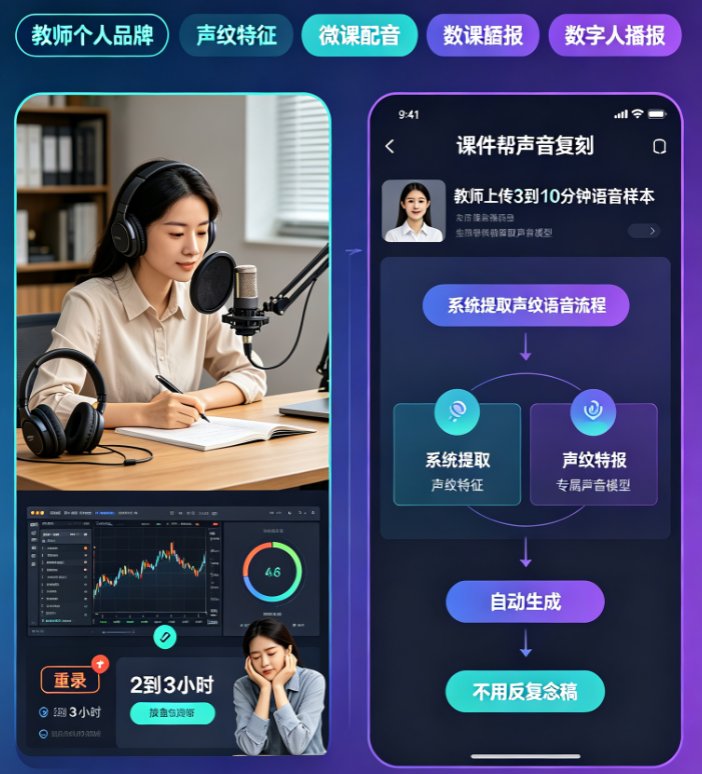
课件帮的声音复刻,解决了“AI配音没个性”这个核心痛点。 它利用AI技术,从你的短音频中提取音色、语调和情绪特征,生成一个能替你说话的“数字分身”。这比传统TTS(文本转语音)自然得多——传统TTS是机器合成,而声音复刻是“嘴替”。
有位老师跟我吐槽过:他花了大半天录了40分钟配音,结果嗓子哑了不说,还因为口误重录了好几段。后来他用课件帮声音复刻,录了30秒的自我介绍,之后所有微课配音都交给AI,效果几乎跟他本人说话一样,他说这才是“一次录制,终身受用”。
咱们可以做个对比,用表格看清楚差异:
| 维度 | 传统TTS | 课件帮声音复刻 |
|---|---|---|
| 音色还原 | 机器感重,像合成音 | 还原个人音色,自然度接近真人 |
| 情绪表达 | 平稳单调,无起伏 | 支持开心、生气、悲伤等6种情绪 |
| 素材需求 | 无需录音 | 最少10秒,推荐30秒 |
| 适用场景 | 通用播报 | 微课讲解、数字人播报 |
数据说话:据优设网评测,MiniMax海螺AI的声音克隆只需30秒音频就能还原情绪,而课件帮与之类似,甚至针对教学场景做了优化。30秒,是声音复刻的黄金时长。
02 课件帮声音复刻实操:三步搞定微课配音
咱们直接进入正题。课件帮的声音复刻功能藏在“数字人播报”里,但你可以单独用它生成音频。整个流程分三步:
第一步:准备一段“合格”的录音素材
不需要专门去录音棚,手机就行。但有几个细节要注意:
- 环境要静:屋里没杂音,关掉空调和窗户。
- 语速自然:像平时讲课一样,不用特意放慢。
- 时长30秒左右:最少10秒,但太短容易失真。
别踩这个坑:有些人拿网上的视频片段去克隆名人声音,课件帮只支持用自己录的音色,这也是为了合规。如果你想用别人的声音,必须先获得授权,否则涉及侵权。
第二步:上传素材并开始克隆
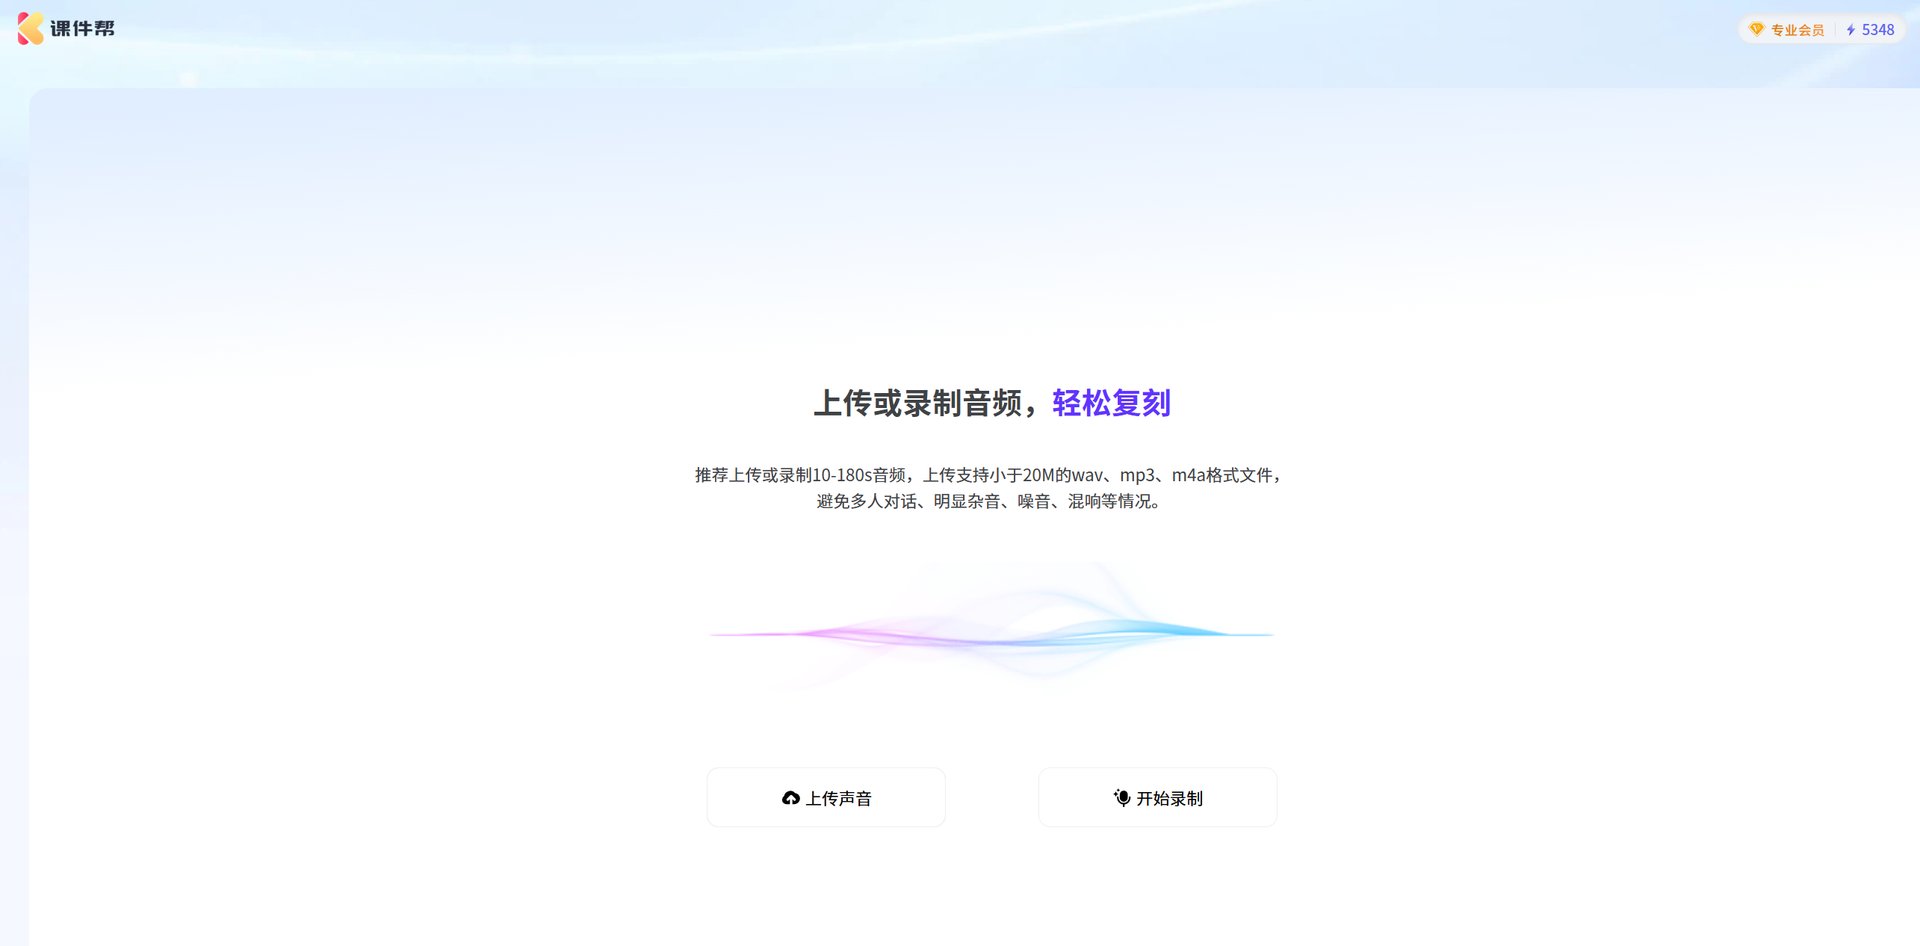
在课件帮后台找到“声音复刻”,上传你的录音。系统会自动分析音色特征,几十秒就能生成你的专属声音模型。
偷偷告诉你:上传后有个“降噪”选项,如果你的录音干净就不勾选,反之可以帮你去掉背景音。克隆完成后,记得给声音取个名字,比如“张老师讲课版”。
第三步:用克隆声音生成微课配音
回到“文本转语音”界面,选择刚才克隆的声音,输入你的讲稿,选择情绪(比如“亲切”或“激昂”),点击生成。几秒后,一段带个人风格的配音就出来了。
有老师反馈,她克隆声音后,还把它用在课件帮的数字人播报上,让虚拟形象用她的音色讲课,学生反馈“像真人老师在屏幕里”。这得益于课件帮的数字人播报功能,声音和形象搭配,效果拉满。
03 声音克隆后,如何让微课更有温度?
克隆声音只是第一步,关键是怎么用好它。课件帮的声音复刻不只是把声音变得“像你”,还支持情绪控制,让你的讲解更有感染力。
举个例子:讲历史故事时,用“悲伤”情绪念《将进酒》的最后一段,比平淡念诵更能打动学生;讲重点时,用“激昂”语气强调,比单调提醒更抓耳朵。课件帮支持6种情绪选择,基本覆盖教学场景。
另外,结合数字人微课,声音复刻能帮你“分身”。你可以录制一段10秒的音频,然后让数字人替你出镜,讲解课件PPT。课件帮的PPT转视频功能可以直接把PPT变成视频,配上你的克隆声音,一条微课从制作到成品不超过15分钟。
这里有个小技巧:如果你需要做系列微课,建议先克隆声音,然后每次只需修改文本,重新生成音频即可。这比每次录一遍省力多了。 有个培训师做了20节产品培训课,原来要录一周,现在一天就搞定,效率提升80%。
04 避坑指南:声音复刻的常见问题
说实在的,声音复刻看着简单,但有些细节不注意,效果会打折扣。这里给你几个提醒:
- 素材质量决定效果:背景音太乱会影响克隆精度,尽量用干净录音。
- 情绪别乱选:选“生气”念课文会像吵架,选“悲伤”讲公式会很怪,请跟内容匹配。
- 版权别踩线:克隆自己声音最安全,用他人声音务必获得授权。
还有一点,有些老师担心数据安全。课件帮提供了私有化部署方案,声音模型可以本地存储,不出校门。这解决了“声音数据外流”的顾虑。
如果你对数字人形象感兴趣,课件帮支持照片定制虚拟讲师,配合声音复刻,你的数字分身就能正式上岗。
05 实测体验:从录音到微课,全程10分钟
为了让你更直观感受,我模拟一遍完整流程:
- 打开课件帮,找到“声音复刻”。
- 用手机录一段30秒的“同学们好,我是张老师,今天我们来学习……”
- 上传录音,等待约30秒,声音模型生成。
- 写一段微课讲稿,选择“亲切”情绪,生成配音。
- 在数字人播报里选择形象,输入文本,让数字人用你的声音讲课。
实际耗时不到10分钟。 如果你有现成PPT,还能导入课件帮AI生成PPT功能,一键产出课件,再转视频配音,全链路自动化。
这里有个数据支撑:课件帮的全链路自动化让微课制作效率提升90%。声音复刻只是其中一环,但却是最个性化的环节。
常见问题
课件帮声音复刻需要多少音频素材?
课件帮声音复刻最少需要10秒音频,但推荐用30秒左右的清晰录音,效果更稳定。过短的样本可能丢失音色细节,超过5分钟则收益递减。
克隆后的声音可以商用吗?
课件帮提供声音复刻服务需遵守平台条款。若用于商业课程或对外发布,建议使用自己录制的声音,避免侵权他人声音。课件帮支持私有化部署以满足学校数据安全要求。
声音复刻后能用于数字人播报吗?
可以。课件帮的声音复刻功能与数字人播报深度集成,克隆音色后可直接选择数字人形象,让虚拟讲师用你的声音讲课,实现个性化教学。
克隆声音的准确度如何?
实测在30秒清净录音下,课件帮可还原说话者的语调、停顿和情绪。相比传统TTS,自然度和情绪表达有明显提升,尤其适合讲解类内容。
录制音频有哪些注意事项?
建议在安静环境用手机或麦克风录制,保持正常语速,避免背景噪音。上传时可开启降噪功能,但原始素材干净则无需处理。