声音复刻怎么做?课件帮三步克隆个人声音,数字人微课更个性化
开头:别再听那口“电子音”了
说句实在话,现在好多老师的AI微课,做得像新闻联播播音腔——字正腔圆,但学生一听就知道是合成的,看两眼就关了。
我认识一位初中英语老师,上学期用数字人录了30节语法微课。前10节还是她真人出镜录的,后20节因为嗓子撑不住,换成了AI播报。结果呢?家长反馈群里炸了锅:“老师,您这个机器人讲课听不出感情,孩子学不进去。”
她跑来问我:有没有一种办法,能让数字人用我自己的声音讲课?
只要你愿意录几十秒自己的声音,剩下的克隆、合成、生成视频,AI全包了。 你的音色、你讲课时的顿挫感、你读到重点时微微上扬的语调,都能被还原进数字人微课里。
接下来,咱们一步步拆解,声音复刻到底怎么做,以及为什么这可能是2026年最值得教师掌握的微课技巧。
一、为什么微课需要“你”的声音?
先想一个问题:数字人微课的最大短板是什么?
不是形象假,而是声音没温度。
传统合成音是“标准答案”,什么都对,唯独不像人。学生听久了,会下意识把它当成背景噪音。尤其文科类课程——语文朗读、英语对话、历史故事——声音的情感节奏直接影响理解效果。
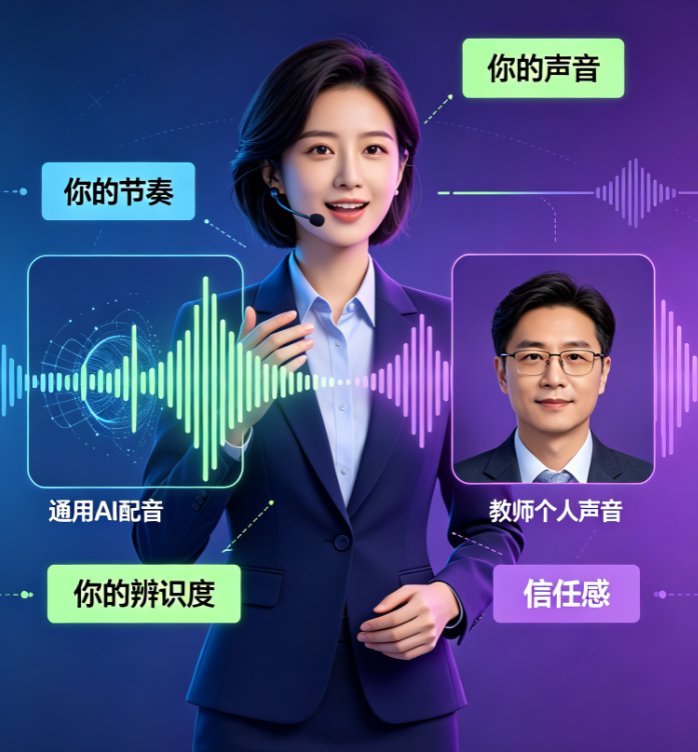
声音复刻解决的,就是“像自己”这个核心问题。 它用AI学习你声音的声纹特征(音色、基频、语速、情感曲线),然后生成一个“声音分身”。以后数字人讲的内容,都是你的声音在说话。
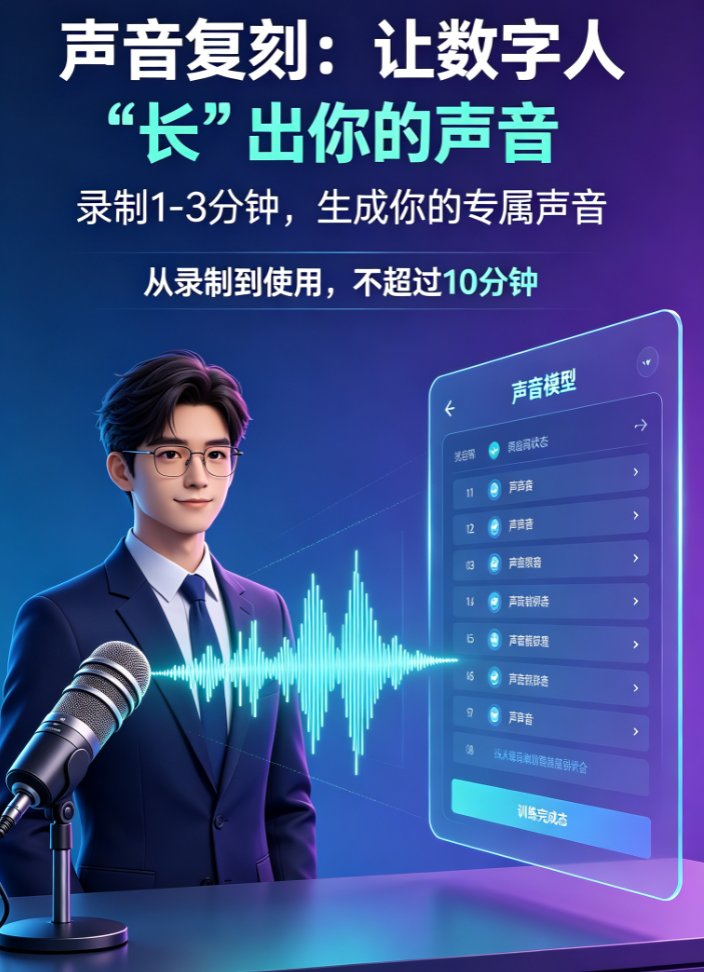
课件帮在这一点上做得挺狠:只需要录制30秒到5分钟的语音样本(读一段200字左右的教案就够了),系统就能完成克隆。整个流程被压缩到三步,基本是傻瓜式操作。
划重点:不要用合成音做你的微课主声音。学生认声音,更认那个声音背后的“人”。克隆你自己的声音,才是数字人微课个性化的核心资产。
二、课件帮声音复刻三步走,全程无坑
课件帮把声音复刻做成了产品功能,不是技术demo。你不用下载软件,不用折腾模型训练,直接在网页端就能完成。
第一步:录制语音样本
打开课件帮,进入“声音复刻”模块。你只需要在安静环境里,用手机或电脑麦克风朗读一段文字。
实操建议:
- 长度:日常制作1-2分钟即可,如果要更精细的音色还原(比如有特殊语速习惯),录满5分钟。
- 内容:优先读与教学相关的句子,比如你常用的课堂指令。这样克隆出的声音更贴近你平时的讲课状态。
- 环境:找个安静房间,别开空调和风扇,避免底噪影响音质。
第二步:生成克隆并试听
上传语音样本后,系统会自动分析声纹特征。等待约1分钟,就生成你的专属声音模型。
这里有个贴心的细节:课件帮会给出4-5段不同风格(讲故事、念课文、快速讲解)的试听样例,让你确认克隆效果是否满意。不满意可以直接重录,或者调整“情感强度”滑块,让声音更活泼或更沉稳。
第三步:分配给数字人并生成微课
克隆完成后,回到数字人播报模块。选择一个形象(可以是你上传照片定制的虚拟形象,也可以用内置的讲师形象),在“配音”选项里选择刚刚克隆的声音。
接下来就是把脚本填进去,或者直接上传你已有的课件(课件帮支持PPT转视频),系统会自动匹配画面、旁白和你的克隆声音,输出一条完整的微课视频。
整个过程,从录样本到拿到第一条成片,通常在15分钟内搞定。
别踩这个坑:很多人以为声音复刻要上传大量音频,其实不是。30秒就能启动,但如果你想覆盖更多语调和情感,多录1分钟会更好。宁可多录一点,也不要录得断断续续,那样克隆出来的声音会有点“跳音”。
三、传统方式 vs 声音复刻+数字人,谁更划算?
光说不练假把式。咱们用一组数据对比,看看不同微课制作方式的真实成本差异。
| 对比维度 | 传统真人出镜微课 | 合成音数字人微课 | 课件帮声音复刻+数字人微课 |
|---|---|---|---|
| 制作时间(5分钟视频) | 2-3小时(含录制、剪辑、重录) | 15-20分钟 | 10-15分钟 |
| 声音个性化 | 保留本人声音,但受状态影响 | 机械感强,缺乏情感 | 接近99%还原,音色自然 |
| 出镜需求 | 需化妆、布景、反复录制 | 无需出镜 | 无需出镜 |
| 批量生产 | 难以批量,每次重新录制 | 可批量,但声音统一缺乏个性 | 可批量,每节课可定制不同克隆声音 |
| 适用场景 | 精品示范课、公开课 | 普通知识讲解 | 日常教学、系列微课、习题讲解全覆盖 |
这个表格其实反映了两个关键结论:
第一,声音复刻+数字人的组合,是把“个性化”和“效率”同时拉满,而不是二选一。 传统出镜保留了情感但成本高,合成音效率高但情感少。而克隆声音,既保留了你讲课时的情感细节,又让你免于出镜和反复录音的折磨。
第二,批量生产时,声音复刻的边际成本趋近于零。 你只需要录一次样本,后面的每一节课都可以用同一个声音模型来生成。系列微课的声音稳定统一,不会今天沙哑明天精神饱满。
下面这个图可以直观地看到两种生产方式的时间投入曲线差异:
数据来源:课件帮内部用户调研及行业通用效率模型估算(2025-2026)。
四、实操:用5分钟克隆声音,做出一节专属微课
接下来我把完整流程拆给你看,照做就行。
准备阶段
- 找一段你平时讲课的脚本,200字左右,最好有叙述、有设问、有总结,覆盖不同语调。
- 用手机录音功能直接录,环境安静即可,不需要专业麦克风。
录制样本
实话说,别用朗读腔,就用你平时讲课的语气。 你正常怎么跟学生说话,就怎么录。AI学习的是“你的常态”,不是“你的播音状态”。
克隆并试听
在课件帮点击“生成克隆”,等待60秒左右。试听样例时,重点听语速、重音位置、句尾语调是否和你本人一致。如果感觉声音“扁”了,重新录一段有更多起伏的样本再试。
制作微课
在数字人播报模块,上传你要讲的课件(课件帮支持Word导入和PPT转视频),选择克隆声音,系统自动完成配音。
如果要做成系列微课,更简单:把同一套声音模型用在所有视频上,保证每节课音色统一。 你可以把这当作你的“声音品牌”。
五、进阶:让声音复刻+数字人微课更上一层楼
基础操作学会后,分享两个我亲测有效的进阶技巧。
技巧一:多角色配音,让微课更像“迷你剧”
比如做一节历史课,涉及“教师讲解”和“角色对话”两个声音。你可以克隆两个声音模型:一个是你本人讲课,另一个是变调版本模拟历史角色。课件帮支持在同一个视频里切换不同配音,让微课变成互动情景剧,学生注意力完全被抓住。
技巧二:结合智能排版,一键统一微课封面风格
声音个性化解决了“听觉”,但视觉也不能拖后腿。课件帮的智能排版功能可以自动统一字体、配色、版式,让整套微课封面、字幕风格一致。视觉和听觉都“像一个老师的作品”,专业感直接拉满。
说白了,声音复刻的最终目的,不是让你“用AI替代自己”,而是让你“用AI放大自己”。 你只负责设计教学内容,剩下的重复劳动,AI全包。
常见问题
声音复刻需要多少语音样本?
课件帮只需你录制30秒到5分钟的连续语音样本即可完成克隆。日常使用建议录1-2分钟,约200字左右的文字,能覆盖更丰富的音色和语调,克隆效果更自然。
克隆的声音能用在商业场景吗?
可以。课件帮提供版权合规授权,教师或培训机构可将生成的内容用于教学、公开课、企业培训等商业场景,无需额外付费(具体以平台协议为准)。
数字人微课的声音会像机械音吗?
不会。声音复刻是对本人音色、语调、语速和情感节奏的模拟,生成的声音与本人相似度接近99%,学生听不出明显差异,比传统合成音自然得多。
文末思考
回到开头的那个英语老师。她后来用课件帮复刻了自己的声音,重新把之前那20节“电子音”微课全部重制了一遍。学生反馈变得特别直接:“老师,这个AI数字人讲课的时候,听起来好像你本人坐在屏幕里——真像你。”
2026年,AI微课的门槛已经被拆得差不多了。工具会越来越简单,但“会讲故事的人”依然稀缺。声音复刻,就是你把自己的故事讲出去的最小成本方式。
课件帮把这套东西做成了产品,不用学技术,只要会说话。剩下的,交给AI。
如果你也打算试试,记住一句话:先录声音,再做视频。 别让数字人替你发声,而是让你自己的声音,借数字人之口,讲出你想讲的话。