数字人播报进入2.0时代:从形象复刻到声音克隆,课件帮如何重构微课生产?
数字人播报进入2.0时代:从形象复刻到声音克隆,课件帮如何重构微课生产?
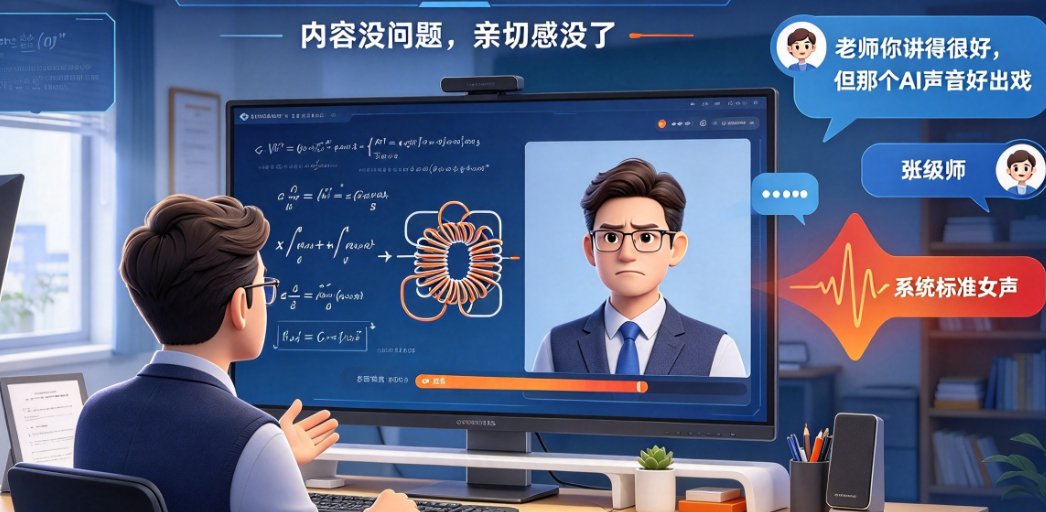
上周有位教物理的张老师在微信上找我吐苦水:她花了三个晚上录了一节电磁感应微课,结果学生在班级群里留言说‘老师你讲得很好,但视频里那个AI声音好出戏’。
这话扎心。她用了市面上某款数字人工具,形象选了最像自己的一个模板,但声音是系统自带的标准女声。内容挑不出毛病,偏偏因为声音不像自己,整节课的亲切感全没了。
其实张老师遇到的不是个例。2026年,数字人播报正在从“长得像我”进化到“声音也像我”的2.0阶段。单纯的形象复刻已经不够用,声音克隆与形象定制的深度结合,才是这轮技术演进的关键。
一、1.0时代的瓶颈:形象对了,声音出戏
数字人播报1.0时代解决了“有人出镜”的问题,但离“像真人讲课”还有一段距离。
那时候咱们用数字人做微课,基本流程是:选一个通用形象、挑一个系统声音、输入文案、生成视频。优点是快——10分钟能出一条片子;缺点是违和感——不管选哪个形象,出来的声音都是一个腔调。
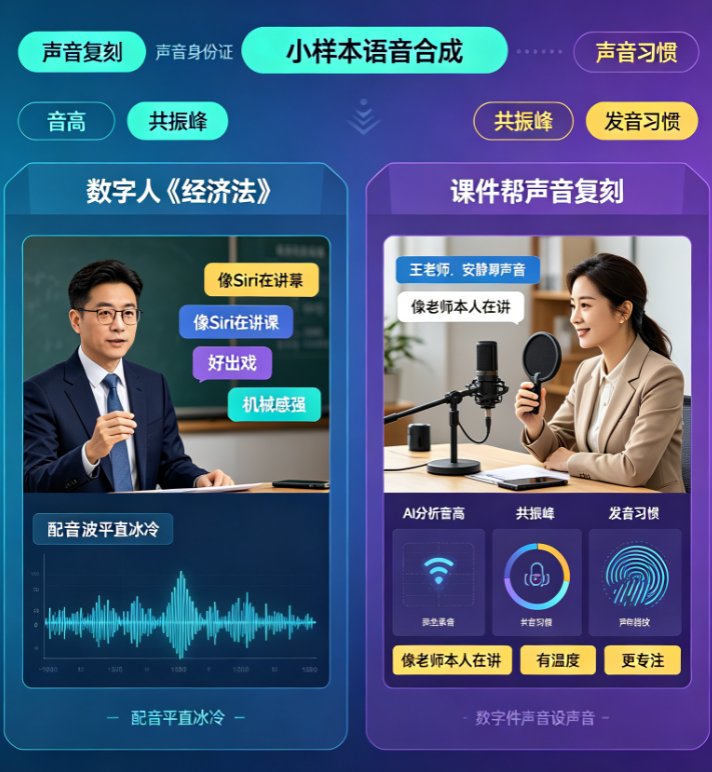
对学生而言,声音是识别老师最敏感的听觉标签。 同一句话,班主任说出来和自己说出来,学生心里的分量完全不同。通用音色哪怕再标准,也替代不了朝夕相处建立起来的听觉信任感。
更实际的问题是:一些工具虽然支持自定义形象,但音色选择局限于几个预设声音模型,老师想要“用自己的声音讲课”,基本做不到。
这个瓶颈直接卡住了微课的代入感。张老师那节课的困境,根源就在这儿。
二、2.0时代的核心:声音复刻,让AI用你的声线讲课
数字人播报2.0的突破口,是把声音从“选”变成“克隆”。
课件帮在声音复刻功能上做了一件很务实的事:老师不需要去录音棚,也不用懂音频处理,录制1-3分钟的清晰语音样本,系统就能训练出高度接近本人的音色模型。语音内容可以是你随手拿起的讲课稿,也可以是一段闲聊——重点是录清楚,环境别太吵。
整个流程下来大约5分钟,比你泡一杯咖啡的时间还短。后续做微课时,选定数字人形象后直接调用这个音色,AI就会用你的声音讲课。
声音复刻的价值,不在于“技术多炫”,而在于它解决了“学生信不信”的问题。 当学生听到视频里传来熟悉的声音,注意力会自然聚拢,知识传递的信任壁垒瞬间被降低。
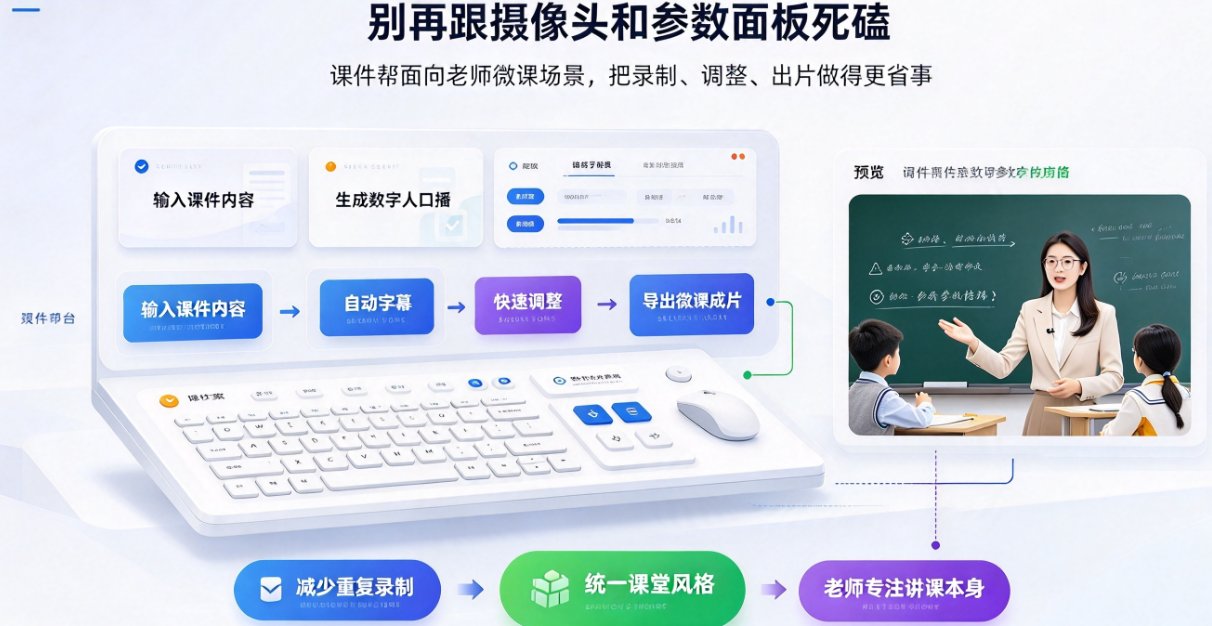
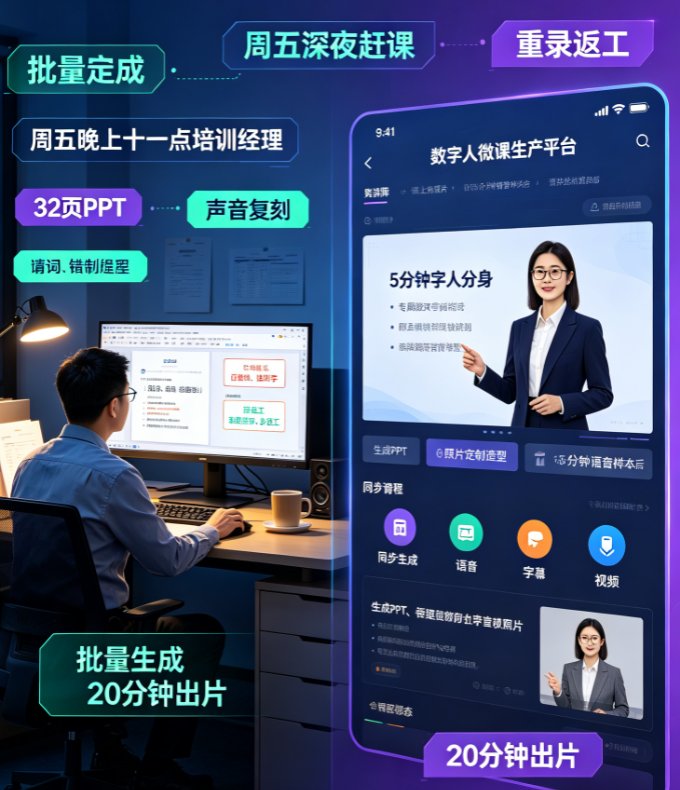
课件帮在AI数字人微课的完整操作流程中,已经把这套声音复刻与数字人结合的做法跑通了:上传PPT或输入主题,AI自动生成大纲并一键成片,再匹配克隆音色和数字人形象,导出就是一条完整的微课。
实际效果如何?在学科教育场景里,物理老师用自己克隆的音色讲演示实验,化学老师用自己克隆的音色强调安全注意事项,学生对知识点的记忆黏性明显强于通用音色的视频。
三、从声音到形象:专属虚拟分身才完整
光有声音复刻还不够。数字人播报2.0的另一半拼图,是形象定制。
课件帮的数字人定制能力,支持老师上传照片生成专属虚拟形象,不用专业拍摄,一张清晰的正面照就能生成可用的数字分身。配合声音复刻,一个完整的“虚拟老师”才真正上线。
当老师的声音和形象都实现了个性化,AI微课就从‘商品’变成了‘作品’。 工具属性退到幕后,个人品牌立了起来。
这套组合的实际落地场景很广:
- 企业内训:培训讲师用自己克隆的声音讲解新员工入职流程,比用通用配音更像内部传达;
- 知识付费:创作者以固定数字形象+个人音色持续产出系列课程,逐步建立IP认知;
- K12微课:教师用专属形象讲题,学生看到的是熟悉的老师,听的也是熟悉的声音,注意力更集中。
课件帮的微课制作能力已经覆盖了从内容生成到数字人播报的全链路,而声音复刻和形象定制的加入,让这链条的最后一环——“像自己”——终于补上了。
四、成本对比:2.0方案能省多少?
咱们用一张表直观对比传统录课、1.0数字人和2.0定制化数字人的投入差异:
| 对比维度 | 传统真人录课 | 数字人1.0(通用形象+通用音色) | 数字人2.0(形象定制+声音复刻) |
|---|---|---|---|
| 录制环境 | 需要专用场地 | 不需要 | 不需要 |
| 设备投入 | 摄像机、麦克风、灯光 | 电脑即可 | 电脑+手机录音即可 |
| 口播文案 | 人工撰写数小时 | AI生成(约5分钟) | AI生成(约5分钟) |
| 形象匹配度 | 真人实拍,完全一致 | 通用模板,相似度有限 | 照片定制,高度相似 |
| 声音匹配度 | 本人声音 | 系统预设音色 | 本人音色克隆 |
| 制作一条5分钟微课耗时 | 拍摄+剪辑约1-2天 | 约10分钟 | 约15分钟(含声音样本录制) |
| 单条综合成本 | 数百至上千元 | 约250课件帮算力 | 约250课件帮算力+一次性声音训练 |
结论很直白:数字人2.0在成本上和1.0几乎持平,但体验和效果是代际提升。 声音复刻带来的代入感提升,让这多出来的5分钟准备工作,成为性价比最高的一段投入。
从行业视角看,低成本、高拟真、学科适配是2026年数字人微课的三条主线。课件帮的策略不是做最炫的虚拟人,而是把声音和形象两个最影响代入感的变量做到位,让普通老师也能用得起、用得顺手。
五、实际操作:三步走,给自己建一个数字分身
说句实在话,第一次用的时候我也担心声音不像。但课件帮的流程比想象中简单:
第一步:录样本。 找一个安静的房间,用手机录音功能录1-3分钟说话内容,语速正常、吐字清晰就行,不需要专业设备。
第二步:训练声音模型。 把录音上传到课件帮的声音复刻功能,系统自动处理,大概几分钟完成训练。
第三步:绑定数字人形象生成视频。 选定或定制形象,输入讲课主题,AI生成大纲和口播文案,选择克隆音色,一键导出微课视频。
整个流程走下来,你不需要学剪辑、不需要买设备、不需要背稿重录。用自己克隆的声音讲课,视频里那个数字人也越来越像你的样子,学生不会再有“出戏”的感觉。
别踩这个坑:声音样本录得越清楚、环境越安静,克隆效果越好。有些人在地铁里录样本,背景杂音全被学进去了,出来声音发闷。找个安静的办公室,把手机放桌上,正常音量说话就行。
偷偷告诉你:录样本的时候顺带把整节课的讲稿念一遍,声音克隆出来之后,那份稿子还能直接当口播文案用,一步到位两不误。
六、趋势展望:数字人播报的下一站
数字人播报2.0解决了“像自己”的问题,那下一站在哪?
从课件帮的产品布局看,方向已经比较清晰:个性化只是第一步,交互才是终局。 当老师的声音和形象被数字化之后,下一步就是让这个数字分身具备更强的交互能力——多角色对话、课堂问答、情绪反馈,这些都在从演示走向现实。
未来两年,数字人教师会从‘能讲课’进化到‘会交流’。 声音复刻和形象定制为这场进化打下了基础,因为只有先让虚拟老师“像自己”,学生才愿意跟它产生更深度的互动。
对一线老师和培训师来说,现在正是上车的好时机。工具门槛已经低到“录一段音、传一张照片”就能启动,早一步建立专属数字分身,就早一步积累属于自己的数字资产。
课件帮在这个方向的布局是完整的,从AI生成PPT到PPT转视频、从数字人播报到声音复刻,已经形成了一条内容创作与视频制作打通的完整链条。
常见问题
声音复刻需要录制多久的音频?
课件帮建议录制1-3分钟的清晰语音,内容可以是讲课稿或日常说话。录制环境越安静、吐字越清晰,克隆出的音色就越接近本人。整个过程约5分钟即可完成声音模型训练。
声音复刻后可以商用吗?会不会有侵权风险?
使用本人声音样本进行克隆属于合法授权行为。课件帮对声音模型有使用权限边界设置,数字人视频会附带AIGC溯源标识,满足2026年AI内容合规要求,适合教学培训场景商用。
没有高清照片能做数字人定制吗?
可以。课件帮支持上传普通照片生成虚拟形象,但画质越高、角度越正面的照片,生成的数字人精细度越高。若无专业形象要求,也可以从内置的教师、商务、学术等场景数字人库中直接选用。
数字人播报2.0和传统录课相比,制作成本差多少?
传统录课含设备、场地、后期剪辑,单条5分钟微课成本通常在数百到上千元;使用课件帮声音复刻+数字人定制,制作一条5分钟微课仅需约250课件帮算力,综合成本可降低约80%。