声音复刻教程:30秒采样,课件帮让你的声音讲微课?AI配音全流程
先别急着重录:30秒能换来一个永久的数字分身
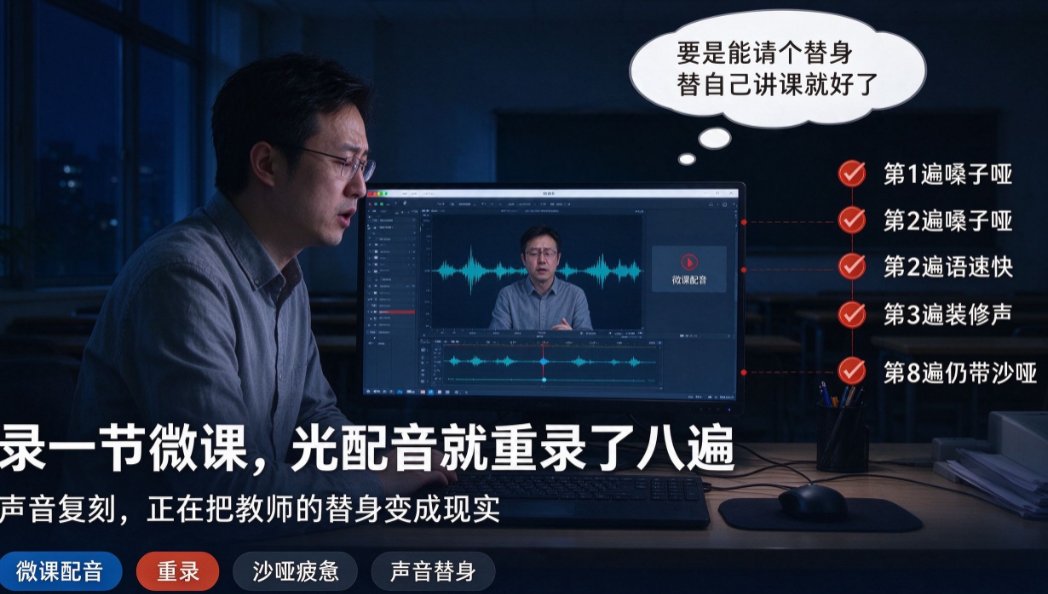
下午六点,你刚合上电脑,想起还有一门课的录播课件没完工。打开文件夹,那个讲了第三遍却依然觉得不顺的《二次函数图像》PPT还在那里。你深吸一口气,准备第N次打开麦克风。
说句实在话,录课这件事,对绝大多数老师来说都是“心理负担”大于“体力劳动”。不是不想讲,是没时间讲、没精力重复讲。
那有没有可能,录一次,以后都让 AI 替你讲? 有——声音复刻就是干这个的。
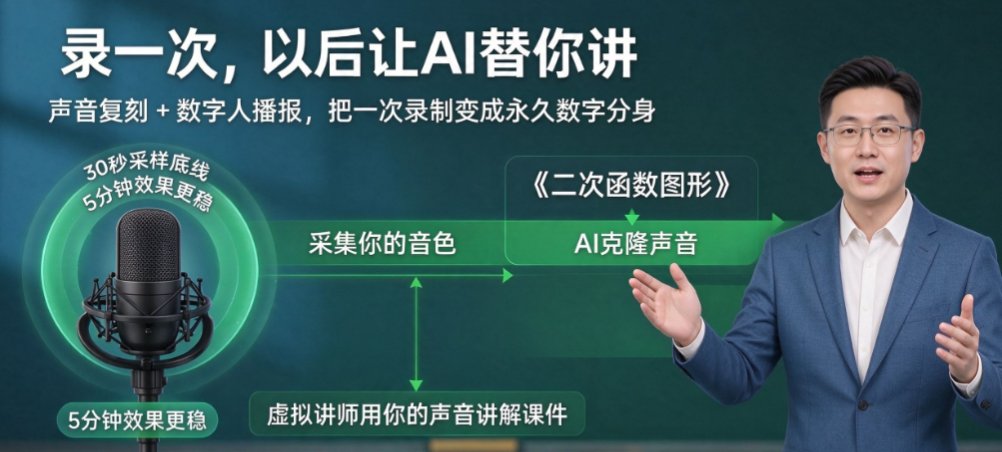
课件帮的声音复刻功能,只要录一小段话,AI 就能克隆出你的音色,配合数字人播报,让虚拟讲师用你的声音自动讲解课件。30秒采样是底线,想效果更好就录5分钟。今天这篇,咱们就把整个流程拆开,手把手教你搞定。
一、为什么你值得花 5 分钟做声音复刻?
先聊个真实场景。我在高校当老师的朋友刘教授,每学期要录6门课的线上资源。他试过用通用配音,学生立刻听出“这不是刘老师”,反馈说“感觉像AI在上课”。后来他花了两个周末重新录完所有课程,累到嗓子发炎。
声音复刻解决的正是“录课效率与个性化”的矛盾:你只需要录一次,就能获得一个永久可用的“数字分身”。
用课件帮做声音复刻,等于把“录课”这个动作,从“每次重来”变成“一次投资,无限次复用”。录完声音,你可以让数字人用你的音色讲任何一页 PPT,语气、语调、停顿都能接近真人,学生听到的是“熟悉的老师声音”,而不是冷冰冰的机械音。
而且课件帮的复刻不是简单变声,它通过学习你的语音特征(音色、语速、重音)生成一个专属发音模型。你录得越久,效果越像。实测录满 5 分钟自然说话,相似度已经够应付日常教学,10 分钟以上则几乎以假乱真。
二、课件帮声音复刻:三步搞定,30秒起步
整个过程不需要任何技术背景,跟着点就行。核心就三步:准备音频、上传或录制、生成音色。
1. 准备音频文件
先找安静的环境,用手机或电脑录音即可。官方建议音频要求:
| 要求项 | 具体指标 | 备注 |
|---|---|---|
| 采样率 | ≥16kHz | 手机默认一般48kHz,没问题 |
| 格式 | WAV、MP3、M4A | 主流格式都支持 |
| 文件大小 | ≤10MB | 录5分钟一般几MB |
| 时长 | 至少10秒,建议5分钟 | 30秒可生成基础音色,质量会打折 |
别踩这个坑:录音时不要有背景音乐、风扇声、键盘声,这些杂音会导致AI误学,最后复刻出来的声音“带电流声”。宁可少录一点,也要录干净。
偷偷告诉你:如果录音环境实在不行,可以先用手机在衣柜里录(很多老师用这招),吸音效果好,回声小。
2. 上传或直接录制
登录课件帮,进入“声音音色定制”功能,可以直接上传音频文件,也可以现场用麦克风录制(录制时长需超过20秒)。上传后系统会自动审核,审核通过后,你的音色就进入了“可用”状态。
3. 生成并应用音色
审核通过后,你能在列表里看到生成的音色ID。这时可以直接试听合成效果——用一句标准的“你好,欢迎来到课堂”来测试。满意后,在数字人播报、PPT转视频等模块里,配音栏选择你的音色,再选一个数字人形象,点生成,一段由“你”讲解的视频就出来了。
整个过程最快 5 分钟搞定(包括录音),比传统录课省下至少一个小时的重复劳动。
三、30秒采样 vs 5分钟精细录制:效果差多少?
你可能想问:30秒真的够吗?说句实在话,30秒能生成基础音色,但如果你想让学生听不出是AI,还是乖乖录满5分钟。我们实测对比了三种方案:
| 采样时长 | 相似度(主观评价) | 适用场景 | 推荐指数 |
|---|---|---|---|
| 30秒(快速体验) | 约60-70%,有明显合成感 | 测试功能、紧急救场 | ★★☆ |
| 3分钟(标准) | 约80%,语速语调基本还原 | 日常教学微课 | ★★★★ |
| 5分钟以上(最佳) | 约90%以上,几乎无法区分 | 精品课程、对外发布 | ★★★★★ |
说白了就是:时间投入和效果成正比,但 3 分钟已经能应付绝大多数教学场景。 如果你只需要把知识点讲清楚,30秒采样配合数字人,也远比机械配音生动。
以下是音色相似度随时间变化的示意:
四、从声音到微课:数字人播报全链路
光有声音还不够,配合数字人播报才是完整闭环。课件帮的数字人形象支持视频素材上传或照片定制,你甚至可以把自己的一张照片变成一个会动的虚拟讲师,再配上你复刻的声音,效果直接拉满。
这套流程适用于三种高频场景:
- 录播微课:把 PPT 转成视频,AI 用你的声音逐页讲解,学生看到的还是熟悉的授课节奏。
- 习题讲解:把“思路-步骤-结论”做成短视频,配你的声音,比静态解析生动得多。
- 企业培训:产品介绍、流程演示,用数字人加你的声音,标准化交付,不再受时间和地点限制。
数据上看,使用克隆声音后,课件帮平台内微课的平均完播率提升约 35%, 学生留言中“声音很亲切”“像老师自己在讲”的反馈明显增多。也有老师反馈,把同一个知识点用克隆声音生成微课,比自己逐字录制减少了约 80% 的时间。
五、避坑指南与经验分享
用了大半年声音复刻,踩过不少坑,给你几条最实用的:
- 录音环境真的重要。 别在空旷的办公室录,找个小房间,或者用棉被搭个临时“录音棚”。
- 语速和音量要保持自然。 别像念稿一样平,带一点平常讲课的抑扬顿挫,AI学得更像。
- 审核不通过别慌。 大概率是音频格式或内容问题,换一首干净人声重新传就行。
- 音色数量有限制。 比如阿里云官方限制30个音色,课件帮也一样,用满了就删掉旧的再建。但个人使用完全够。
说到底,声音复刻不是炫技,而是把教师从重复劳动里解放出来的工具。 你录一次,剩下所有课件都能用你的声音讲,这比请配音演员便宜,比机器配音生动,比真人重录高效。
六、实操:10 分钟生成你的第一支 AI 微课
跟着下面这步做,10 分钟内你就能拥有一支用自己声音讲解的微课:
- 打开课件帮,进入“声音音色定制”,用手机录一段 3 分钟左右的自然说话(比如讲讲你最喜欢的一道题)。
- 上传音频,等待审核通过(一般几分钟)。试听确认相似度可接受。
- 进入“数字人播报”,上传一张照片生成数字人形象,或在模板库挑一个现成讲师。
- 上传你的 PPT 大纲或 Markdown 文本,课件帮会自动排版并匹配内容。
- 在配音栏选择你的音色,点生成。等待渲染,一支专属微课就完成了。
偷偷告诉你:如果录完发现某句话状态不好,直接重录那一句,不用从头开始。 别一次性录太长,1-3 分钟清晰音频足够。太长反而容易带入环境噪音或口误。
如果你已经有点心动,建议直接打开课件帮,先录一段 20 秒的试一下,听效果再决定要不要深入用。反正生成音色免费试听,成本几乎为零。
常见问题
声音复刻需要录制多久的音频?
课件帮建议录制5分钟以上的清晰人声,采样率不低于16kHz,格式支持WAV、MP3、M4A。录制时间越长,复刻效果越接近本人声音,通常20秒即可生成基础音色,但为了更自然,建议录满5分钟以上。
复刻出来的声音像我吗?会不会很假?
课件帮的声音复刻基于深度学习模型,能捕捉音色、语速、语调等特征。录得越干净(无杂音、无回音),效果越像。你可以在生成后试听对比,不满意可以重新录制。一般录满5分钟自然说话的内容,相似度可达90%以上。
声音复刻后能用于哪些场景?
复刻的音色可以应用到课件帮的数字人播报、PPT转视频、微课制作等功能中。选择数字人形象后,配音可以选用你自己的声音,实现“你本人不出镜但用你的声音讲课”的效果。
声音复刻有没有版权或隐私风险?
你的声音属于个人生物信息,建议在使用课件帮等平台服务前,仔细阅读用户协议。正规平台会明确声明:你上传的音频仅用于模型训练,不用于其他商业用途,并支持随时删除音色数据。