声音复刻平民化:2026数字人定制趋势与课件帮的个性化教学场景探索
开头钩子
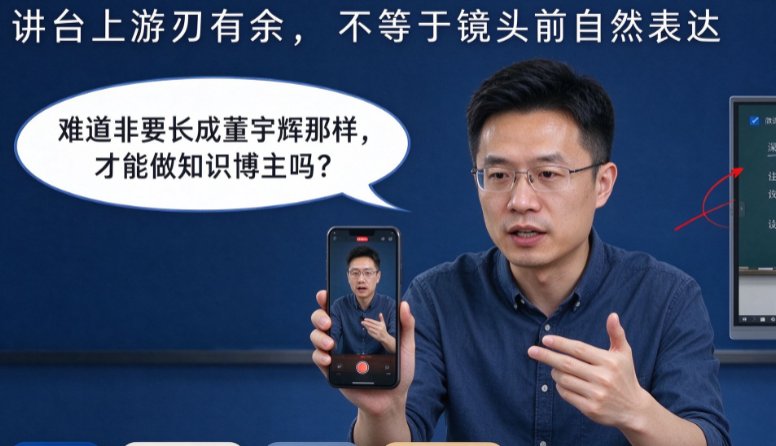
上周,一位教了十年物理的刘老师在微信上跟我吐槽:学校要求每个老师录微课,她对着手机镜头讲了二十遍,不是卡壳就是表情僵硬,最后实在没辙,把PPT拍成视频交差,结果被教研组长批“没有温度”。她问我:“难道非要长成董宇辉那样,才能做知识博主吗?”
我说,刘老师,2026年了,你的声音和面孔,早就不再是录课的瓶颈。 声音复刻和数字人定制,已经从大厂的“秀肌肉”技术,变成了普通老师电脑里一个能点开的按钮。今天咱们就聊聊,这件事是怎么发生的,以及你该怎么用它把自己的微课做出“个人品牌味”。
一、传统录课到底有多痛?
说句实在话,咱们当老师的,没几个是天生镜头型的。你让一个在讲台上挥洒自如的人,对着冷冰冰的摄像头重讲一遍同一个知识点,那种“对着空气演戏”的别扭感,能把人的表达欲生生掐灭。
- 时间成本:一门10分钟的微课,从写稿、录到剪,折腾一整天是常态。
- 形象包袱:发型乱了、表情僵了、背景吵了,全都得重新来。
- 成本支出:想做得专业点?找外包定制数字人形象报价5000元起步,还要等排期,效果还未必像你。
这背后的核心矛盾是:教学内容的产出效率,被“真人出镜”这件事死死卡住了。 咱们缺的不是讲知识的能力,而是一个能替代本人反复出镜、又不失个人特色的“分身”。
二、声音复刻平民化:你的声音,5分钟变成数字资产
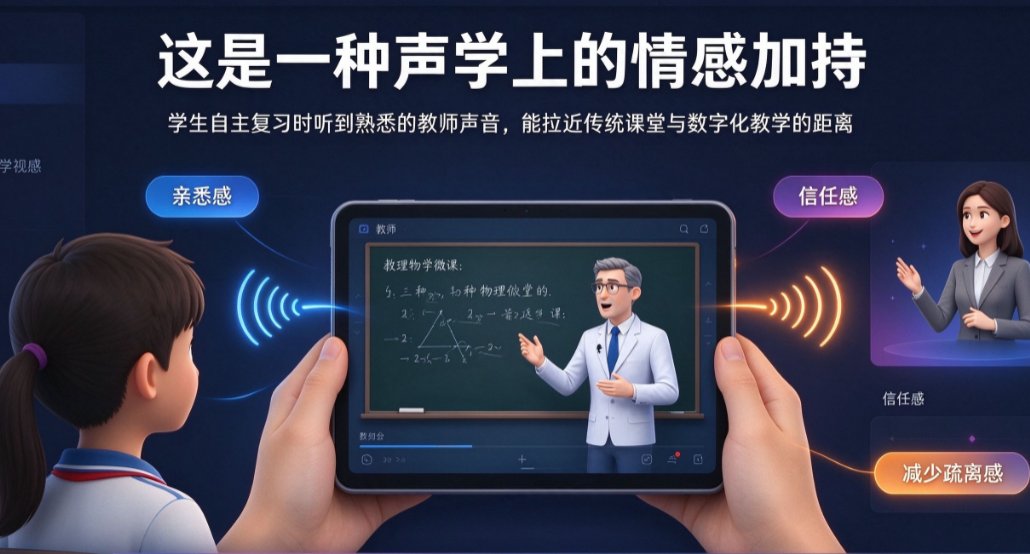
2026年,声音复刻技术已经成熟到“傻瓜式”操作。课件帮只需要你录制30秒的清晰人声,就能克隆出专属音色,匹配度达到可用级别。 刘老师后来试了一次,把一段讲“牛顿第二定律”的音频放出来,她女儿在客厅喊了一句:“妈,你在屋里偷偷录课呢?”
这就是声音复刻的意义——它把“录课”这件事,从“表演”变成了“配音”。
具体怎么做?三步走:
- 准备素材:找一个安静的房间,用手机原声录制30秒自然语速的朗读内容,别加戏,别播音腔。
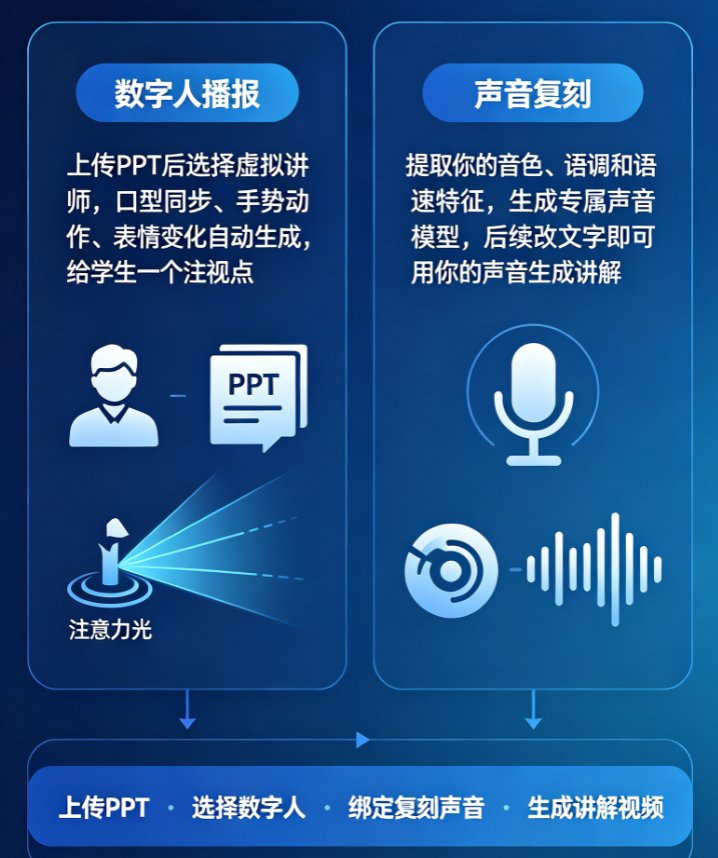
- 上传克隆:在课件帮里选择“声音复刻”功能,上传音频,系统自动提取音色、语调特征,5分钟生成专属模型。
- 应用到播报:在数字人口播模块中选择该声音模型,输入文案,AI就能用你的音色念出来。
说白了,以前录课像“拍电影”,现在录课像“发语音”。 你只需要写好讲稿,剩下的发声活儿,交给AI。而且声音模型是长期资产,这次录完,下次还能接着用,风格还高度统一。
偷偷告诉你一个避坑点:录素材时别选在安静但空旷的客厅,会有回声,影响克隆的清晰度。找个堆满书的书房,效果最好。
三、数字人定制:一张照片,生成你的虚拟讲师形象
声音解决了,脸的问题呢?课件帮的数字人定制,支持上传一张正面高清照片(1080p以上,无遮挡),就直接生成一个专属虚拟讲师形象。不需要绿幕,不需要专业摄影棚,更不需要花大几千找外包建模。
| 对比维度 | 传统3D建模定制 | 课件帮照片生成 |
|---|---|---|
| 制作周期 | 5-10个工作日 | 10分钟 |
| 成本 | 5000元起 | 近乎零 |
| 情感表现 | 固定模板,呆板 | 8种微表情+6种情绪自动切换 |
| 技术门槛 | 需专业团队 | 任何人可上手 |
| 口型同步率 | 波动大 | 超95% |
数字人形象生成后,不是一张死板的“平面照片”。在课件帮里,你可以调节它的语速、语调,还能选情绪标签——比如讲到重点时选“严肃”,讲到趣闻时选“兴奋”。虚拟讲师会跟着内容自动匹配表情和肢体动作,口型同步率超过95%,看起来就像真的在讲课。
这就是数字人和“动图PPT”最本质的区别:它懂得用表情辅助表达,而不是对着镜头念稿。
四、场景探索:声音+形象,如何重塑你的教学IP?
当声音复刻和形象定制合体,产生的不是“1+1=2”,而是“一个可批量复制的你”。
我们看一个真实案例。成都一所小学的校长,以前找外包公司定制数字人做国旗下讲话,花5000元,做出来的形象学生直呼“像恐怖谷机器人”。后来他改用课件帮,上传自己的照片,录了30秒语音,10分钟生成了虚拟分身。配合课件帮的“严肃”情绪标签,AI自动生成了一段带表情、带手势的讲话视频。结果怎样?学生参与度提升40%,制作成本降低80%。
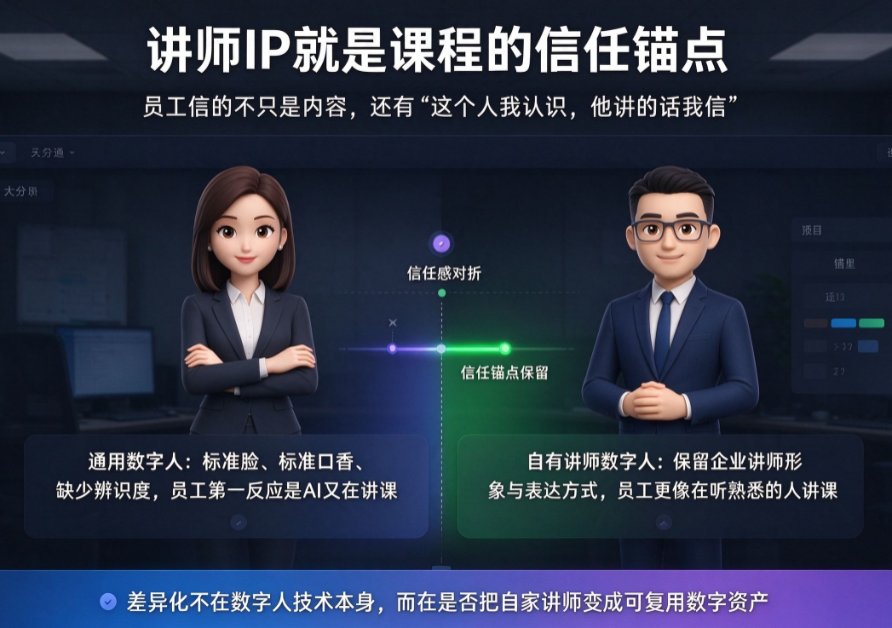
这个案例背后,是一个更大的趋势:数字人正在从“企业营销工具”变成“教师个人品牌资产”。
具体到场景,你可以这样用:
- 微课主讲:把整学期的重点知识点,都用你的数字分身录成5分钟短片,发在B站、视频号上,积累粉丝。
- 翻转课堂:把预习讲解做成数字人视频,让学生在家看,课堂用来讨论和答疑。
- 家长会同步:用克隆声音录制班级通知,比冷冰冰的文字通知有温度多了。
这已经不是“要不要用”的问题了,而是“谁先用,谁就先建立教学IP”的问题。 当别的老师还在为出镜焦虑,你已经用一个虚拟分身稳定地输出高质量内容了。
想更系统地了解从照片到专属虚拟讲师的完整流程,可以看看这份数字人定制攻略,里面有分步截图和参数建议。
五、给老师的三条实操建议
如果你也想在今年跑通“声音+形象”这条新赛道,这三条建议拿走就能用:
- 先克隆声音,再定制形象。声音是内容的核心,形象是锦上添花。先把一门你讲得最熟的课的音频克隆出来,感受一下“你的声音+AI”的流畅度。
- 从一门课开始试点。别贪多,把一门原本最不想录的课做成数字人微课,对比一下投入产出比,数据比感觉更可信。
- 长期主义对待IP。数字人形象和声音模型是可积累的资产,不要做一次就丢。持续用同一形象、同一音色更新内容,你的教学品牌会越来越清晰。
最后说句实在话:教学的核心从来都是内容,不是那张脸。 数字人技术不是让你变成“网红”,而是让你从重复录制的苦役中解放出来,把时间花在真正有价值的教学设计上。
课件帮把声音复刻、形象定制、表情驱动整合在一个平台里,至少让这件事不再需要“技术团队”。一个老师,一台电脑,半小时,就能拥有一个专属于自己的虚拟分身。这就是2026年,技术给教育行业最实在的一份礼物。
常见问题
课件帮声音复刻需要准备什么素材?
只需录制30秒左右的清晰人声(安静环境、手机即可),系统会自动提取音色特征,5分钟内生成专属声音模型。录制时避免背景噪声,语速自然,效果更佳。
数字人定制一定要用视频素材吗?
不一定。上传一张正面高清照片(不低于1080p,避免帽子、墨镜遮挡)即可生成基础形象,视频素材可生成更精细的3D模型,但照片方式已满足大部分微课场景。
声音复刻和数字人形象如何组合使用?
在课件帮数字人播报界面,选择已定制的形象和声音模型,输入文案后即可生成口型同步、带表情动作的播报视频。支持调节语速、语调、情绪标签(如严肃、兴奋)。
克隆后的声音能用于商业用途吗?
课件帮支持将生成的数字人形象和配音导出为标准视频文件,适用于微课、企业培训、科普视频、知识付费等场景,也支持通过协作分享生成二维码分发,但需确保内容符合AIGC相关合规要求。
想了解更多数字人微课的制作细节,可以翻翻课件帮的微课制作分类页,里面有不少实操技巧。