2026声音复刻走进课堂:教师用课件帮AI克隆嗓音,批量生成带温度微课
2026声音复刻走进课堂:教师用课件帮AI克隆嗓音,批量生成带温度微课
半夜十一点,李老师还在电脑前录微课。
她是北方一所重点中学的物理老师,学校要求每个教研组一学期产出12节微课。白天上课、批作业,晚上回家才能安静录一会儿。可录制这东西,状态不好,一句话说错就得重来,一条十分钟的视频,她常常录到凌晨。
这不是她一个人的困境。
过去两年,AI配音工具已经能读稿,可那声音——字正腔圆、毫无温度,学生在弹幕里写“像机器人上课”“听着犯困”。真人录音虽然好,成本又是真高:时间、精力、状态,哪一样都在劝退老师。
说句实在话,2026年这个矛盾终于有了一个不错的解法:声音复刻。
教师录30分钟声音样本,AI克隆出你的专属嗓音,之后输入文字,就能批量生成由你本人声音讲解的微课。这不是概念,课件帮已经把整条链路做成了傻瓜式操作。
一、声音复刻,为什么在2026年突然就成了微课标配
很多人以为声音复刻只是“把声音换成一个AI音色”,其实不是。
真正有价值的地方在于:你不用再为一条视频反复开口录十几遍。
咱们算笔账。传统真人微课制作,从脚本到成片,一个人至少要花4到6小时,其中一半时间是耗在录音上。录完一遍听,有杂音;再录一遍,语气不对;改个稿子,又得从头来。
而声音复刻解决的核心,不是“替代你”,是把你在录音上最重的那块石头先搬走。
一旦声音克隆完成,你只需要输入文字、选择数字人形象,AI就会用你的音色把内容讲出来。遇到临时改稿,改稿就够了,不需要重录。遇到批量课程,也不用拼嗓子。
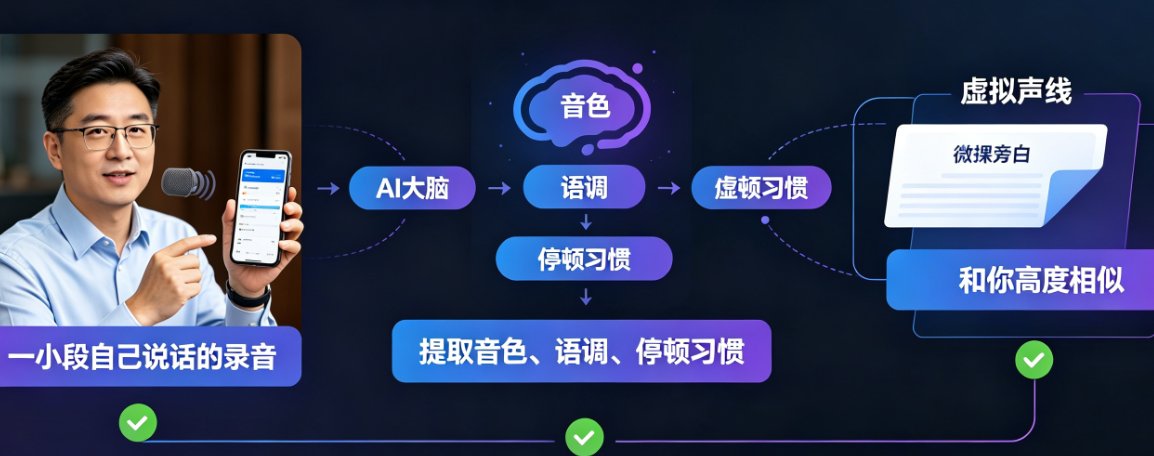
这背后是2026年AI技术的两个成熟点:一是声音采样精度够高,几十秒样本就能提取出音色、语速、停顿习惯等特征;二是生成成本大幅下降,从过去专业级设备才能做,到如今在浏览器里花几分钟就能搞定。
说白了,声音复刻把“真人出镜”和“批量生产”这两个过去对立的需求,第一次缝合在了一起。
二、教师用课件帮声音复刻,三步生成你的专属音色
课件帮的做法很直白,把传统上要请专业团队才能完成的声音克隆,压缩成了三个步骤。
第一步:录制30分钟声音样本
你不需要专门的录音棚。找一间安静的房间,用手机或电脑麦克风,录一段自然的讲解,内容可以是教材段落、课文朗读、或者就是平时讲课的口吻。
课件帮系统会自动分析你的嗓音特征——音色、语气、语速、停顿习惯。 它会从样本中提取出“你的口语节奏”,而不是单纯复刻一句话一个字。
小贴士:录的时候别刻意端着,就当你正常给学生上课。越自然,克隆出来的音色越像你。
第二步:系统生成克隆音色,试听两个版本
克隆完成后,课件帮会提供基础版和高保真版两个声音版本。
这一步一定要听,别光看名字选。
- 基础版:声音更利落,适合知识点密度高、解说节奏快的课程;
- 高保真版:更像你本人,保留更多语气细节,适合个人IP、精品微课。
试听后选一个满意的版本,输入名称保存。如果都不满意,可以返回重新上传样本再来一次。这个细节挺人性化——不是让你在不满意里二选一,而是给你重来的机会。
第三步:把声音匹配到微课里,批量生成
保存克隆音色后,你就能在课件帮里直接调用它。无论是导入PPT生成微课,还是配上数字人形象做口播,声音都是你自己,不用每次重新录。
一个教研组、一个培训部门,甚至一个知识付费创作者,只要完成一次声音克隆,后面所有内容的产出速度会快到你惊讶。
别踩这个坑:有些老师做完声音复刻后,发现音色不太像,就急着重录一整段。其实你可以只重新录几个句子,课件帮会自动学习调整,效率高得多。
三、效率对比:声音复刻 vs 传统真人录制
| 维度 | 传统真人录制 | 课件帮声音复刻+AI微课 |
|---|---|---|
| 单条10分钟微课录音 | 4-6小时(含重录、剪辑) | 10-15分钟(文本已定型时) |
| 状态依赖 | 高,感冒、疲劳直接影响质量 | 低,输入文字即可稳定输出 |
| 改稿成本 | 重新录制相关段落 | 改文字后AI自动重读 |
| 批量课程 | 难以持续输出 | 一次克隆,多课程复用 |
| 声音辨识度 | 天然真实 | 高保真版保留个人语气、停顿习惯 |
从表格里能直观看到:声音复刻最大的价值不在单条微课的录制,而在长期、批量、稳定地输出内容。 这对教师做系列精品课、培训机构搭建课程体系、知识付费创作者持续更新,帮助是结构性的。
四、哪些场景最适合用声音复刻,我已经看到真实跑通的例子
1. 保险金融与咨询服务
这类人最缺的不是专业内容,而是稳定的输出时间。客户买的不是一条视频,是对你的信任。 声音辨识度越高,私域里的熟悉感越强,咨询转化越好。
2. 教育培训机构与职业讲师
我见过一位讲职业考试的老师,去年冬天为了录一套课连续说了两个星期,嗓子直接哑了。最麻烦的是后面课程一更新还得补录。先用声音复刻把音色沉淀下来,后面无论是PPT转讲解还是知识点拆分,都轻松太多。
3. 企业内训与HR部门
新员工培训、合规宣讲、制度解读,这些内容高度重复,又需要固定的“讲师声音”来传递亲和力。用声音复刻+数字人形象,一套内容能反复用,还能快速适配不同部门。
4. 个人IP与知识付费创作者
一个人运营多个平台,最怕分身乏术。今天录抖音、明天录视频号、后天还要改小红书版本,光录音就把人拖住了。有声音资产,内容节奏会一下子轻很多。
说句实在话,课件帮不只解决“能不能做”的问题,更重要的是让老师把精力从重复劳动里解放出来,回到真正的教学设计和内容打磨上。
五、2026年,声音复刻+微课的趋势已经清晰
在2026年,声音复刻已经不是极客玩家的玩具,而是教师内容生产的效率工具。 它和数字人形象、AI智能排版、PPT一键转视频共同构成了微课制作的新工作流。
相关趋势数据也能佐证:数字人形象与声音克隆的结合已是企业培训和知识付费项目的标准配置,制作成本相较传统方式可降低80%以上,效率提升接近90%。更多细节可以参考我们对2026年数字人微课个性化趋势的分析。
从“一个人录到深夜”到“一个人管理一条声音生产线”,这个转变正在各个教研组里悄然发生。
这背后不只是技术的成熟,更是内容生产观念的进化。老师不再需要把“讲课的声音”当作一次性消耗品,而是可以把它变成像教案一样可复用、可迭代的资产。
所以,如果你也正卡在录音慢、状态不稳定、批量做微课做不动的困境里,不妨试试课件帮声音复刻,先花30分钟录一段自己的声音,再让它替你持续输出。
关于声音复刻之后的数字人形象定制、以及如何让虚拟讲师更自然,你也可以看看我们之前梳理的数字人照片定制虚拟讲师攻略,和声音复刻三步让AI用你的音色讲课。
常见问题
教师用课件帮声音复刻克隆嗓音,需要多久?
课件帮声音复刻从上传样本到生成可用音色,最快几分钟就能完成。系统会自动分析你的嗓音特征(如音色、语速、停顿习惯),只需录制少量音频样本,就能生成高保真克隆音色,基础版和高保真版可自由试听选择。
教师声音复刻后,能用来批量生成微课吗?
完全可以。克隆完声音后,课件帮会自动将音色匹配到微课讲解中,配合AI数字人形象、PPT转视频等功能,老师只需把课件文本导入,就能批量生成带自己声音的微课视频,适合课程体系化输出。
声音复刻出的AI嗓音像本人吗?
课件帮声音复刻支持高保真版,能保留你说话的语气和停顿习惯,辨识度很高。如果你做个人IP或系列课程,学生听到的就像你本人一直在讲,而不是冷冰冰的机器配音。
哪些学科的教师最适合用声音复刻做微课?
语言类(语文、英语)、职业考试培训、企业内训、知识付费咨询都很合适。这些场景对内容的长期一致性要求高,反复真人录会累,声音复刻能帮你保持输出频率,同时维持熟悉的“听觉人设”。
声音复刻和传统录音相比,优势在哪?
传统录音每次都要调整状态、剪辑降噪,一条10分钟微课常常要重录三四遍。声音复刻只需一次录制,之后输入文字就能生成语音,效率提升80%以上,成本大幅降低,且每次输出音质稳定。


