声音复刻对比合成音:课件帮如何让微课配音更自然有个性?
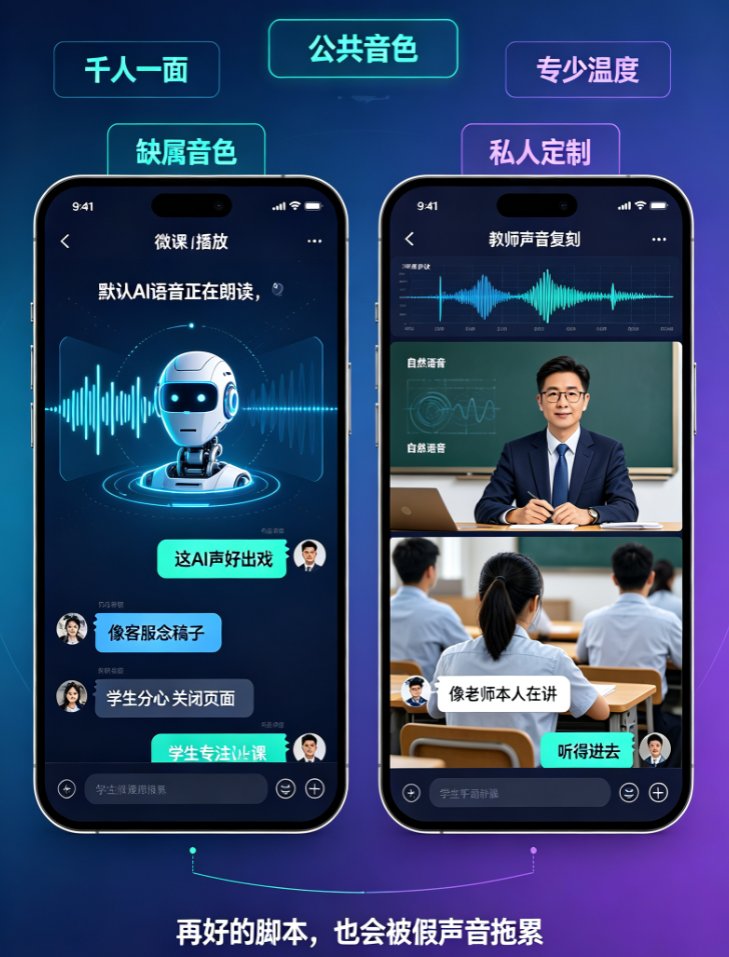
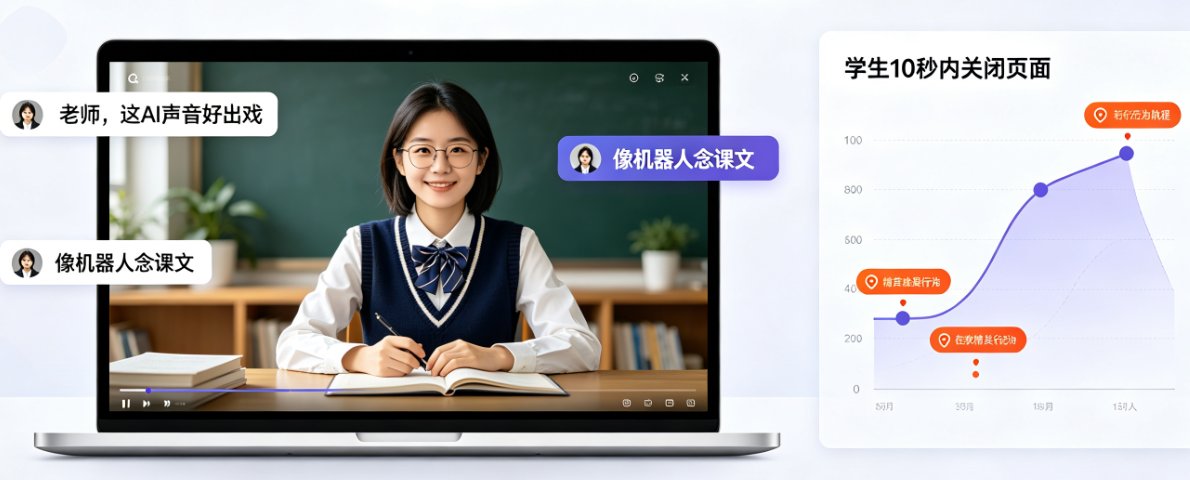
你有没有过这种体验?辛苦做了半天微课,配完音一播放,学生评论全是——"老师,这AI声音好出戏","像机器人念课文"。
说句实在话,我也在B站刷到过不少这样的课件:画面精美、逻辑清晰,可那口电子音一开口,10秒之内你就想关掉。明明老师自己的声音挺好听、挺亲切,非要让AI代劳,结果学生不但没被"吸进去",反而被"推出去"。
问题出在哪儿?不怪AI,怪咱们用错了工具。今天咱们就把话说透:普通AI合成音和声音复刻,到底差多远?教师播音到底该选哪条路?
01 你听到的"电子腔",真的只是"音色"问题吗?
很多老师以为,AI配音不好听是因为"音色"不真实。其实不然。
普通的AI合成音,音色本身已经做得不错了,而且选项多得很,男声女声童声、温柔亲切大气——单听截图里的试听片段,每个都挺好。但一放进成片里,问题就暴露了:它不接你的地气。
什么意思?就是缺乏"人味"。
你讲课有你的节奏:讲到关键处会停顿、会放慢,讲笑话时会带点笑意,强调时会有重音。这些"口头习惯"和"情绪起伏",是大模型合成音很难复刻的——因为它们是从海量数据里学出来的"平均人",不是你。
所以,真正让你觉得"像机器人"的,不是音色,而是缺少个人韵律和表达习惯。
结论很直接:想要微课有辨识度,就得让AI"借用"你的声音,而不是替你换一个声音。 这就是声音复刻和普通TTS最本质的分水岭。
02 声音复刻与AI合成音:7个维度的硬核对比
不能光说概念,咱们直接上表格。以下是基于实际教学使用场景的对比总结:
| 对比维度 | 普通AI合成音 | 课件帮声音复刻 |
|---|---|---|
| 音色还原 | 标准库音色,人人一样 | 1:1还原你的音色 |
| 韵律节奏 | 平稳,常有"朗读感" | 保留个人停顿与语速变化 |
| 情感表现 | 基本平稳,难以起伏 | 还原重音、语气和情绪 |
| 个性化 | 低,千篇一律 | 高,自带辨识度 |
| 准备成本 | 无需准备 | 录制3-5分钟样本 |
| 适用学段 | 通用、低龄科普 | 各学段,更适合同一老师IP持续输出 |
| 与数字人配合 | 表情与声音割裂感强 | 音素级时间戳对齐,口型更自然 |
说白了就是:普通合成音是"换一张脸",声音复刻是"给你一个数字分身"。
再看量化感受。下面这张图是我常给教师朋友分享的一个直观对比,真实感和自然度的差异非常明显:
别的不说,"个性化"这一项直接拉开一个身位。数据背后是原理差异:声音复刻不是从音色库里挑一个"最像"的,而是直接以你的声音为基底做生成。
03 实操:5分钟,让数字人用你的声音讲课
我知道你想问:"听起来不错,但操作难吗?"
不骗你,比做PPT简单得多。 课件帮把声音复刻做成了三步走:
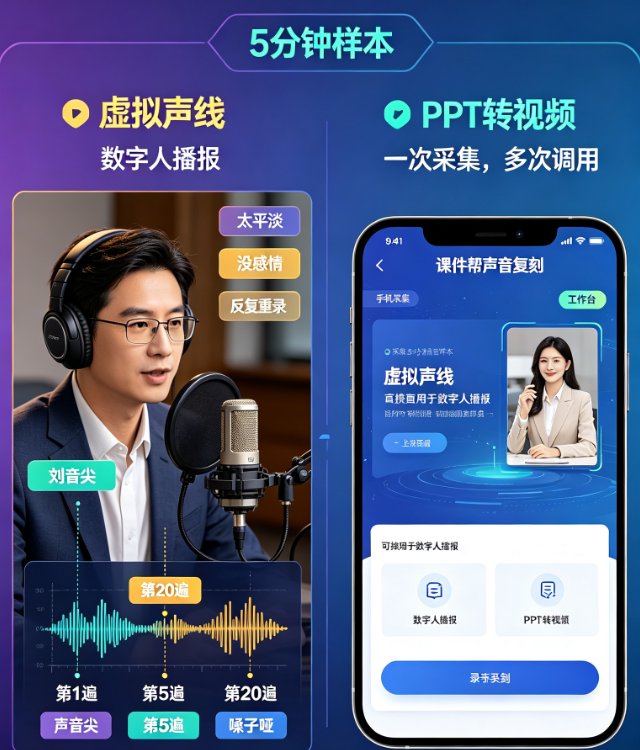
第一步:录音采样。 找一个安静房间,用手机或电脑麦克风,照着屏幕给的文字稿念一段。不需要专业设备,200字,大概3-5分钟, 正常说话就行,不用端播音腔。
第二步:一键训练。 上传音频后,大模型会自动提取你的音色、语速、停顿习惯、句尾上扬等特征。这一步全自动,你只需要等几十秒到几分钟。
第三步:绑定数字人。 在课件帮数字人播报中,把你刚复刻的音色设为旁白声,输入讲义文字,数字人就会"用你的声音"开口讲课。配合音素级时间戳,口型对得上,表情跟得上。
一位高中物理老师跟我分享过他的用法:他用复刻声音批量录制了20节习题课,课后学生跟他说——"老师,听着就是你,但你终于不用反复录了。"
这背后就是课件帮一直说的数字人微课个性化趋势。声音不像自己一直是数字人微课最大的出戏点,现在被原生复刻解决了。想深挖这层,可以看这篇:数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课。
别踩这个坑:别用电话录音或KTV背景音素材。 背景杂音会干扰特征提取,宁愿环境安静一点,也别用降噪插件硬修。有杂音的样本,做出来的声音像蒙了一层纱。
04 什么情况用复刻,什么情况用合成音?
不是让你每节课都上复刻,你得会挑场景。
强烈推荐用复刻音色的场景: - 系列微课(同一门课,固定"声优",形成老师个人IP) - 习题讲评(需要"讲"的感觉,不止是"读") - 知识点答疑库(学生会反复听,熟悉感很重要) - 企业内训产品介绍(要像真人讲师在讲)
普通合成音也能用的场景: - 过渡性旁白、片头片尾 - 低年级绘本类泛读音频 - 临时赶制、对风格无要求的内部资料
一个判断标准:如果这节微课代表你的专业形象,学生要反复听、细琢磨,那就值得用复刻。
05 给老师的避坑清单(手把手版)
- 录音别贪长。 5分钟左右的高质量样本,比20分钟的凑合样本效果好得多。质量优先于时长。
- 文本别选文言文。 选口语化、贴近你平时讲课节奏的文本,模型能学到更真实的你。
- 学段不同,语速策略不同。 小学低段可以稍慢一点,初高中保持正常讲课语速即可。
- 复刻声音也需"试听校对"。 生成后先听一遍,如果某段语气不对,可在文本里加标点或分词调整。
- 数据安全要问清。 涉及个人声纹,属于敏感生物信息。用私有化部署或混合云方案更稳妥,课件帮2026年也有专门的数据安全趋势分析,可以翻翻。
06 结语
说到底,微课是你的名片。画面、动画再华丽,声音一开口"露馅",整个专业度都会打折扣。声音复刻的意义,不只是"更像人",而是让每一个课件都有"你"的痕迹。
课件帮的核心逻辑一直很朴素:让不懂技术的老师,也能用上专业级的教学工具。声音复刻也好、数字人播报也罢,都是朝着"让AI隐形、让你的表达显形"这一目标去的。
对了,多角色对话式微课这两年火起来了,一节课里师生问答、角色演练,用不同复刻音色各配一角,输出效果很惊喜。有兴趣的可以看看数字人微课多角色对话的趋势分析。
常见问题
声音复刻和普通AI合成音有什么区别?
普通AI合成音是预先训练的标准音色库,所有人用起来都一样;声音复刻则基于你录制的小样,克隆你本人的音色、语调和情感。课件帮只需要5分钟语音样本,就能生成属于你自己的专属声线,让微课讲解带上个人辨识度。
课件帮声音复刻需要录多久的声音?
正常语速朗读一段200-300字的文字,约3-5分钟即可完成采样。无需专业录音棚,手机在安静环境下就能录制,系统会自动提取音色、韵律和说话风格的特征。
声音复刻的微课听起来自然吗?会像机器人吗?
基于大模型技术的复刻方案机械感明显弱化。课件帮声音复刻重点还原你说话的停顿习惯、情绪起伏和节奏变化,比通用合成音自然得多。你可用复刻音色配合课件帮数字人播报,生成有温度的教学视频。
复刻的声音能用在所有微课里吗?
适合讲解类、知识科普类、习题讲评等多数教学场景。如果你需要多角色对话,也可以复刻不同角色声音在同一节课中切换,让课堂更生动。建议在正式发布前做小样试听,确认效果。
声音复刻会不会泄露我的声音隐私?
课件帮提供私有化部署和混合云方案,声音数据可留在校内或机构本地。具体安全策略可参考课件帮2026年数据安全部署方案,支持按需隔离存储。