声音复刻怎么用才自然?课件帮5步打造专属课堂配音,学生爱听
开场:别再让“电子音”毁掉你的微课
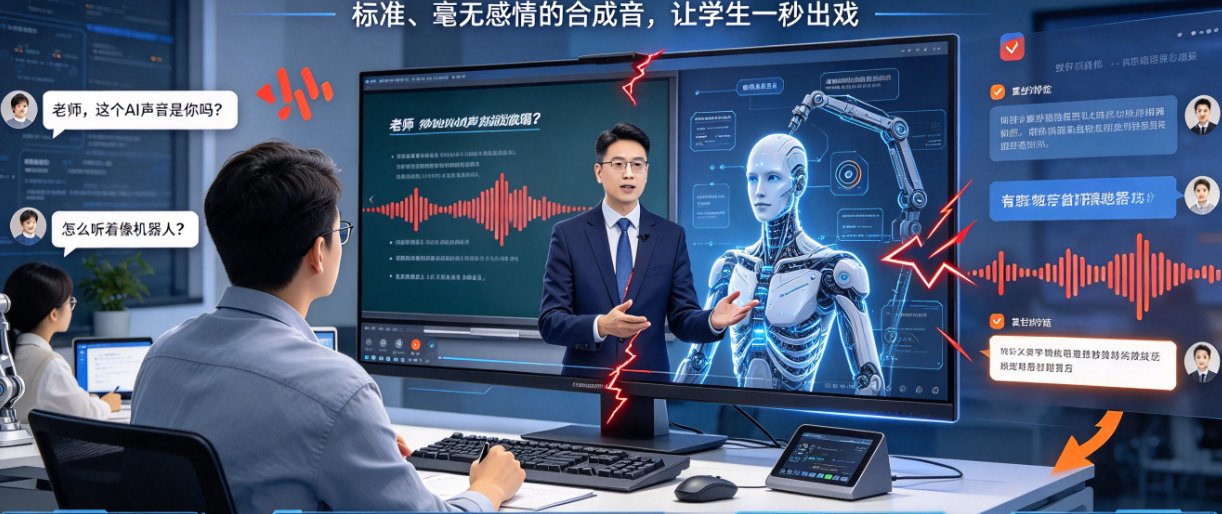
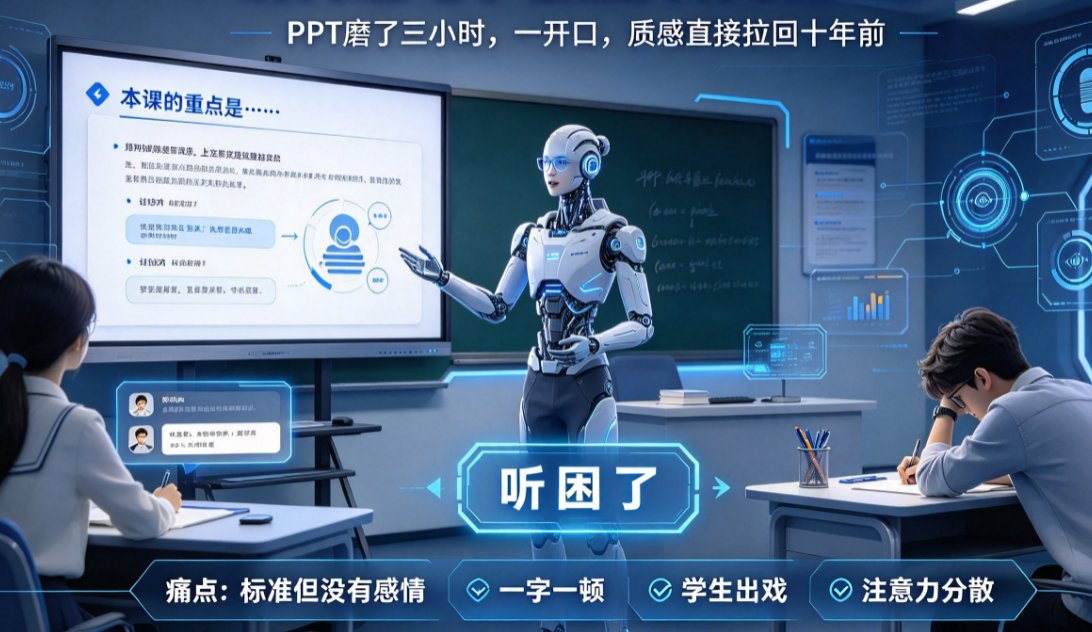
上周三晚上,我盯着屏幕里那位数字人老师,听它用标准到没有任何感情的普通话,一字一顿地讲着“本课的重点是……”。屏幕外的学生,在评论区打了三个字:“听困了。”
说句实在话,这个场景你大概率也遇到过。你花了三小时打磨 PPT,一页页配图、调版式,结果一开口,声音把整节课的质感拉回了十年前。微课里最容易被忽略、却最影响代入感的,恰恰是声音,它不是数字人形象,而是那个“嗓子”。
一、为什么说“声音”才是数字人微课的命门?
形象再逼真,声音不对劲,学生秒出戏。
数字人微课这两年火得不行,但大家伙儿一股脑扎进“形象”的坑里:选个网红脸、挑一套西装。可你有没有发现,真正让你觉得“这课像老师讲的”,往往是声音——那种熟悉、有温度、带点口头禅的嗓音。
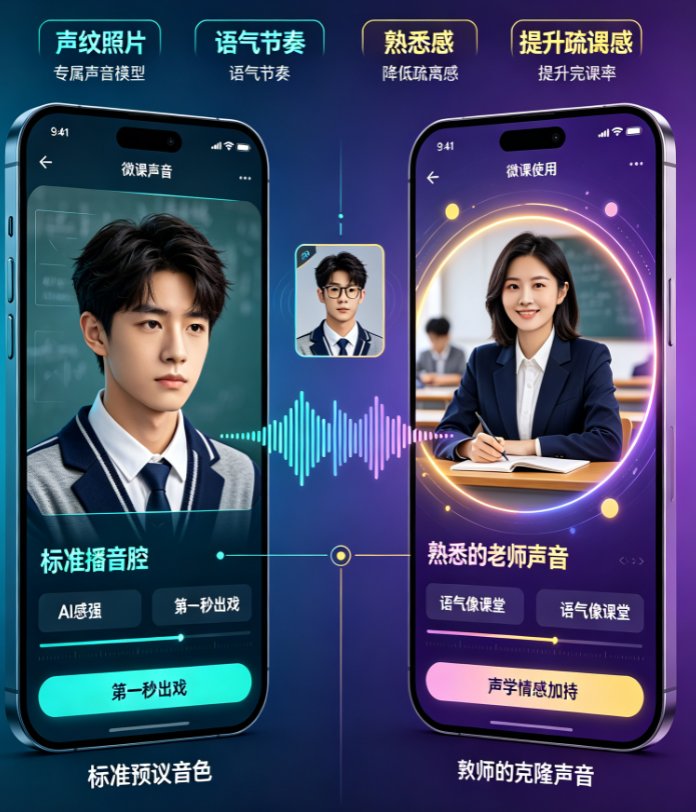
声音复刻,就是把你自己的声音“借”给数字人,让它替你讲课。 这跟选一个平台默认的 AI 音色完全是两码事。默认音色是“千人一声”,你的学生一耳朵就能听出这是机器在念稿;而克隆你的声音,学生听到的是“老师本人”,注意力自然就拢住了。
说白了,这就是一种信任感的迁移。学生信你这个人,才愿意听你这个“分身”讲课。
二、声音复刻没那么玄乎,课件帮 5 步搞定
别被“克隆”“复刻”这种词吓着。实际操作下来,其实就是一套标准化流程,全程用不上十分钟,就能生成一个专属于你的音色库。
第 1 步:找个安静的地儿,打开课件帮的声音复刻入口
打开课件帮,进入“声音复刻”功能。找一个安静的房间,手机麦克风或电脑耳麦都行。关键是别在风扇底下录,也别在马路旁边录——噪音和混响是声音复刻最大敌人,比你普通话标准不标准影响还大。
第 2 步:录 1-3 分钟语音,念稿或自由发挥都行
按提示录制一段语音,建议长度在1-3分钟。内容可以是你的讲课稿,也可以随意读一段文字。别绷着,用你平时上课的腔调说就行,越自然,复刻出来的声音越像“人话”。
偷偷告诉你:录稿子时稍微带点停顿和语气起伏,效果会更好。 平铺直叙地念,AI 学到的就是“念稿”的声音,而不是“讲课”的声音。
第 3 步:提交模型,等个几分钟
语音上传后,系统会自动进行模型训练。这个时间通常几分钟内就能完成。你该干嘛干嘛去,回来喝口水,音色模型就建好了。
第 4 步:试听、微调,直到“像你自己”
生成之后,一定要试听。拿一段你以前的录音,跟复刻出来的声音对比一下。有些词、有些音调可能偏了,这时就要用到参数微调——语速、停顿、尾音上扬都可以调。别嫌麻烦,这一步直接决定最终效果的自然度。
第 5 步:关联到项目,数字人从此“用你的嗓子”
在课件帮里新建或打开一个 PPT 转视频 / 数字人播报项目,把刚刚复刻好的音色设为默认配音。之后生成的所有视频,都会用你的声音来朗读。从此,你的历史课件、新做的微课,声音全部统一,辨识度拉满。
三、几个直观对比,帮你快速做决定
| 对比维度 | 平台默认 AI 音色 | 真人录制 | 课件帮声音复刻 |
|---|---|---|---|
| 制作成本 | 免费/低价 | 3-5小时(含设备、场地、剪辑) | 5分钟录制+几分钟训练 |
| 音色辨识度 | 低(千人一声) | 高(就是本人) | 高(就是本人) |
| 更新迭代 | 无法更新 | 每次重录 | 随时重录覆盖 |
| 批量应用 | 可用 | 每次都要重录 | 一次复刻,全库通用 |
| 表达自然度 | 中等偏机械 | 自然 | 接近真人,需微调 |
看清楚了吗?声音复刻的本质,是用 10 分钟的前期成本,替代 3-5 小时的反复录制的后期麻烦。 这还没算上你在录音棚里嗓子干哑、情绪崩盘的时间。
别踩这个坑:不要拿手机在嘈杂环境里随便录。声音复刻是“给多少料出多少菜”,底噪大的录音,复刻出来的声音不仅不清亮,还会有一种挥之不去的“电流感”,后期怎么调都救不回来。
四、声音复刻之后,微课的“质感”才真正起来
我认识一位高校老师,上个月刚用这套流程把一门 8 节的选修课全部改成了数字人微课。她说以前上课,学生看 PPT 是 PPT,听讲是听讲,两件事儿是割裂的。现在数字人用她的声音讲课,口型对得上,声调是熟悉的,学生课后反馈“像老师在面前讲课一样”。
这背后其实是情感化教学在起作用。数字人解决了“谁来讲”的视觉问题,声音复刻解决了“谁在讲”的听觉问题。两者合璧,微课才真正跨过“像视频”的门槛,变成“像课堂”。
对老师来说,声音复刻更是一种“内容资产”的沉淀。 你录的这些语音样本、生成的声音模型,是可复用的数字资产。以后不管出书、开专栏、做 IP、录企业课,这个声音都是你的——它不会累,不会生病,不会因为今天嗓子哑了就上不了课。
五、课件帮的完整闭环:不只是复刻声音,而是重建整个制作流程
声音复刻不是孤立的功能。在课件帮里,它是整条数字化课件生产线上的一个环节——
从AI 生成 PPT(输入主题自动出内容),到PPT 转视频(一键配旁白),再到数字人播报(选形象、用你的声音开口),全程打通。声音复刻解决的是“最后一个 1%”的问题,但它撬动的是整个微课“像不像你”的质变。
如果你对这条链路感兴趣,可以看看课件帮这边整理的几篇深度实操:2026数字人微课个性化趋势:声音复刻+形象定制,课件帮如何让每位教师拥有专属数字人? 和 数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课,里面有不少从真实教学场景出发的细节,值得翻一翻。
六、用课件帮,把这 5 步串成一条线
最后帮你把实操流程浓缩成一张速查清单,下次做微课照着走就行:
- 准备:安静环境,1-3 分钟讲课稿;
- 录制:用平时上课的语调,别念稿;
- 复刻:提交模型,试听微调;
- 应用:在数字人播报 / PPT 转视频里设为默认音色;
- 沉淀:保留模型,后续所有视频一键调用。
说句实在话,声音复刻这功能,属于“用了就回不去”的那种。 你尝过一次“学生说这课像你讲的”的快乐,就再也不想回到“电子音念稿”的年代。
如果你今年有批量做微课、培训视频的打算,建议先花 10 分钟把「声音复刻」跑通,剩下的交给课件帮,让 AI 替你开口讲课。
常见问题
Q:声音复刻和直接选AI音色有什么区别? A:直接选AI音色是平台预设的标准音,千人一声,辨识度低;声音复刻是克隆你自己的声音,学生听到的是熟悉的声音,代入感和专注度明显更高,也能延续你线下课堂的信任感。
Q:声音复刻一般要录制多长时间? A:建议录制1-3分钟的清晰语音即可,内容可以是讲课稿或任意文字。关键是环境安静、收音清晰,噪音和混响会直接影响复刻效果。
Q:录完一次能永久使用吗?后期能改吗? A:录完一次后,你的专属音色会保存在账户中,之后所有PPT转视频和数字人播报项目都能重复调用,无需重新录制。后期可随时重录覆盖,更新音色。
Q:用课件帮声音复刻做的微课会显得很机械吗? A:不会。课件帮的声音复刻基于少量样本进行音色建模,配合语速、停顿等参数调整,输出自然度较高。在数字人播报中,口型与声音同步,整体效果远好于普通TTS。