AI声音复刻进课堂:2026教师定制数字人声音的三大趋势
开头:你还在为微课里的"电子音"头疼?
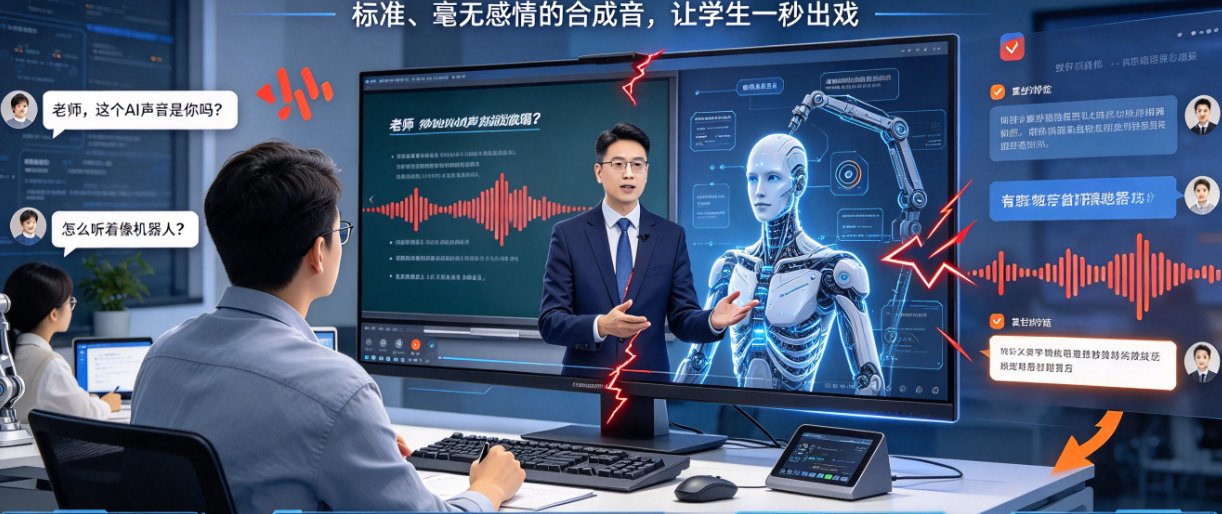
说个真事。我认识一位高中物理老师,去年开始用数字人做微课,省去了化妆、换衣服、调灯光的麻烦,但学生总在评论区问:"老师,这个AI声音是你吗?怎么听着像机器人?"
她哭笑不得。数字人的画面越来越真实,但声音一出来就"破功"了——那种标准的、毫无感情的合成音,让学生一秒出戏。
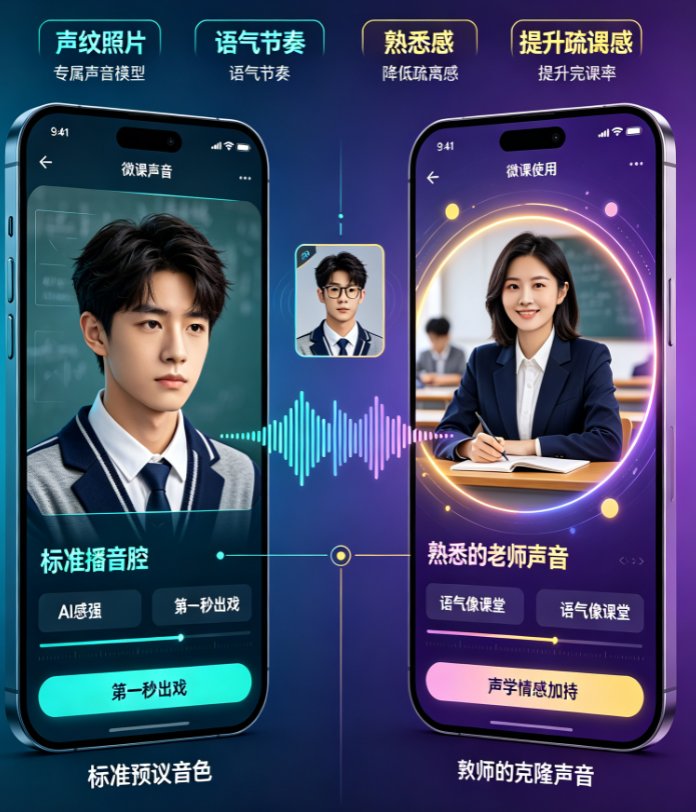
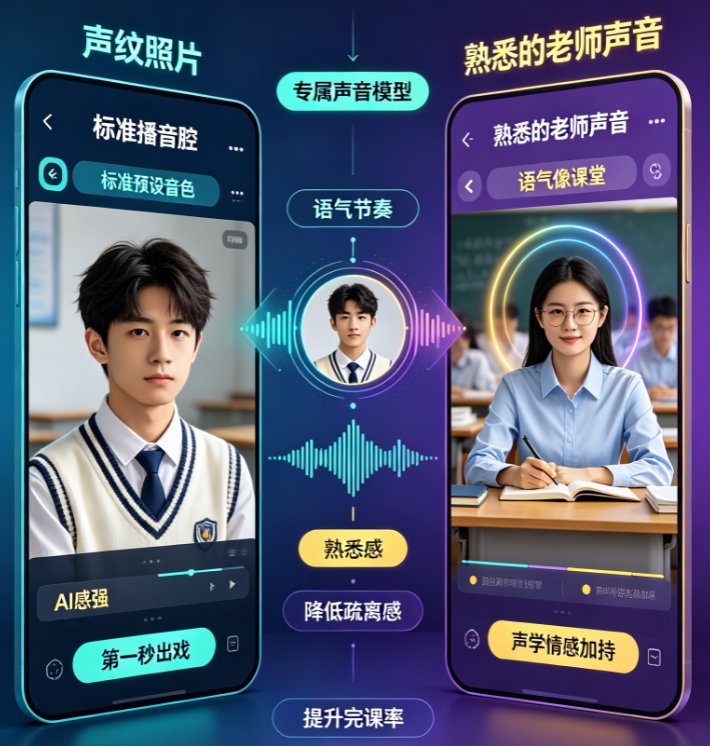
2026年,这个问题终于有了答案:声音复刻。让AI学你的声音,然后用你的音色去讲课。不再是"像机器人",而是"像你本人"。
这篇文章咱们不绕弯子,直接聊三件事:声音复刻凭什么在2026年进课堂、对老师到底意味着什么、以及你该怎么用起来。
一、趋势一:从"技术尝鲜"到"教学刚需",声音复刻门槛低到离谱
前几年提到声音复刻,多数人觉得这是科技博主玩的东西,离一线教学很远。到了2026年,情况完全变了。
生成式语音合成模型的快速迭代,让声纹特征提取所需的样本时长从分钟级压缩到秒级,合成语音在音色还原度、自然度和情感表达方面均有显著提升(来源:2026年声音克隆工具全面盘点,品牌评测官)。
这意味着什么?
说句实在话,现在的门槛低到离谱——你不需要专业录音棚,不需要声卡麦,只需要找一个安静房间,用手机录3-5分钟自己平时讲课的内容,剩下的事交给AI。
课件帮的声音复刻功能,正是按照这个逻辑设计的:
| 对比维度 | 传统真人录制 | 声音复刻+数字人播报 |
|---|---|---|
| 单节微课耗时 | 4-5小时 | 约45分钟 |
| 出镜要求 | 需化妆、换装、调光 | 无需出镜 |
| 声音一致性 | 受状态影响(感冒、疲劳) | 100%一致 |
| 批量生产 | 难以实现 | 轻松支持 |
| 成本 | 高(时间+精力) | 低(一次性投入) |
说白了,以前录一节微课要折腾半天,现在从Word大纲到成品视频,全程几乎不用人工干预。声音复刻在2026年已经不是"锦上添花",而是教师做微课的基础设施。
偷偷告诉你:课件帮的声音复刻只录制约50句话(3-5分钟),几分钟就能生成可用的声音模型,连我这篇稿子用的都是类似流程,效果你们感受下。
二、趋势二:从"统一音色"到"千人千声",教师定制自己的声音IP
2026年声音复刻最大的变化,不是技术本身,而是它开始回应教师的真实需求。
一个常见的痛点:标准AI女声/男声虽然清晰,但讲数学公式、物理概念、古诗文时,总差点"人味儿"。更别提有些学科需要读生僻字、多音字、方言发音——通用合成音经常读错。
这时候,教师自己的声音反而成了最好的"模板"。你录的语音样本里,包含了你对字词的发音习惯、语气停顿、重音强调,AI学到的不是一个标准音,而是"你的教学风格"。
课件帮将声音复刻与数字人定制深度打通,教师录完声音后,可以:
- 选择或上传自己的数字人形象(照片即可生成);
- 输入文字,自动生成带自己声音的微课视频;
- 批量处理系列课程,一次录音,长期使用。
在2026年,声音复刻正在从"用技术克隆声音",转向"用技术放大教师的个人特质"。你不需要变成播音员,你的普通话说得稍微带点口音也没关系——那正是学生熟悉的"老师的声音"。
别踩这个坑:别以为声音复刻是一次性的。建议每学期更新一次声音模型,因为你的声音会随着年龄、状态微变,保持模型新鲜度才能让学生觉得"这就是现在的老师"。
三、趋势三:从"工具"到"资产",每位教师都该拥有"数字分身"
趋势三听起来有点玄,但其实特别实在。
想想看:以前你录一节课,录完就结束了,声音随着视频存在那儿,很难复用。现在你的声音被AI"记住"了,它变成了一个可以反复调用的数字资产。
这意味着什么?
- 录一次,用一年:这学期录的声音样本,下学期做新微课还能用;
- 跨课程复用:你录的数学课声音,做物理习题讲解一样能用;
- 多平台分发:同一个声音,可以生成抖音竖版短视频、视频号口播、企业培训视频,不用重新录。
声音,正在成为教师最独特的数字IP。它比形象更私人——你换个发型、换副眼镜,学生可能认不出,但你一开口,全班都知道是你。
这与数字人IP化趋势完全吻合。2026年,声音复刻+形象定制,正在让每位教师拥有专属数字人(来源:课件帮《2026年数字人微课个性化趋势》)。
课件帮在这一块做得比较完整:声音复刻解决"是谁在说话",数字人定制解决"是谁在出镜",智能排版和PPT转视频解决"内容怎么组织",全链路串起来,教师只需要输入文字,剩下交给系统。
划重点:2026年做微课,别再纠结"要不要出镜",而是要想"怎么让数字人更像你"。声音就是最直接、最便宜的"拟真方案"。
四、实操:5步用课件帮打造你的声音分身
光说趋势不落地,等于没说。咱们直接上实操,从零到一用课件帮完成声音复刻并生成微课,全套流程走下来大概40分钟。
第1步:准备录音环境
找个安静的房间,用手机或电脑麦克风录音即可。背景噪音越小越好,避免回音。不建议在空旷的教室录,回音会让声音模型不干净。
第2步:录制语音样本
在课件帮进入声音复刻功能,按照提示朗读约50句文本(约3-5分钟)。朗读时保持自然语速和情感,就像平时讲课一样。准备一段300~500字的讲稿,涵盖日常授课常用语,效果更佳。
第3步:等待模型生成
提交后,AI会自动分析你的声纹特征,生成高拟真度声音模型。通常几分钟内即可完成。
第4步:测试声音效果
输入一段文字,试听克隆声音的效果。如果觉得不够自然,可以重新录制或调整参数。这一步建议多试几遍,找到最接近你本人状态的设置。
第5步:搭配数字人播报
选择你喜欢的数字人形象(或用照片定制),输入文字,即可生成带你自己声音的微课视频。支持批量生成,系列课程轻松搞定。
相关阅读:如果你对数字人定制感兴趣,可以看看这篇《数字人声音不像自己?课件帮声音复刻三步让AI用你的音色讲课》,里面拆解了更详细的参数调整方法。
五、写在最后:你的声音,值得被AI记住
说句实在话,声音复刻这件事,技术上已经足够成熟,但真正落地的关键,是愿不愿意花5分钟录一段音。
2026年,声音复刻技术正在重新定义教师的内容生产方式。你的声音,不再只是上课时的工具,而是可以沉淀、复用、增值的数字资产。
如果你还在犹豫是否要尝试,我的建议是:先花5分钟录一段声音,用课件帮免费体验一下声音复刻的效果。不花一分钱,感受一下AI克隆你声音的惊艳效果,再决定要不要系统性地用起来。
毕竟,声音是你最独特的教学标签,值得被AI记住。
想看看声音复刻和数字人结合后,微课能做成什么样?可继续阅读《数字人微课爆发元年:2026年教师用AI数字人替代真人出镜的5大场景》,里面有详细的场景拆解。
常见问题
Q1:声音复刻真的只需要几分钟就能完成吗?
是的。课件帮的声音复刻功能只需录制约50句语音样本(约3-5分钟),即可生成高拟真度声音模型,之后输入文字即可用该声音播报,支持数字人视频合成。
Q2:声音复刻的效果能保留方言或特殊语调吗?
目前主流AI声音复刻技术已经能较好保留原声的语调、语速和情感节奏,但方言和极特殊语调的还原度取决于训练数据量。课件帮在标准普通话和常见英文口音上表现优秀,日常教学场景完全够用。
Q3:数字人播报时,声音复刻的延迟大吗?
课件帮采用云端实时推理,从输入文字到生成数字人播报视频通常只需1-3分钟。批量生成时系统会自动排队处理,不影响日常使用。
Q4:没有专业的录音设备,用手机录的语音能用吗?
完全能用。找一个安静的房间,用手机或电脑自带麦克风录音即可。建议朗读一段300~500字的讲稿,涵盖日常授课常用语,效果会更好。