教师微课配音总不像自己?课件帮声音复刻三步打造专属讲师音色
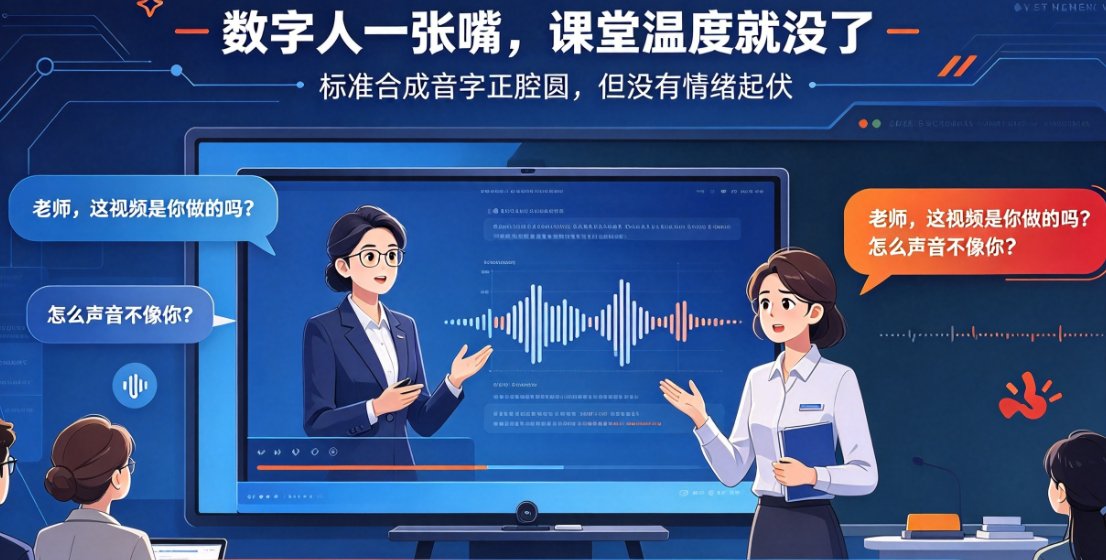
我懂你现在的尴尬——辛辛苦苦做了一节微课,画面、动画都挺精致,结果配音一出来,学生问“老师这是你吗?怎么听着像个机器人?”
说句实在话,这是2026年做微课最常见的翻车现场。普通AI配音软件里的音色虽然多,但翻来覆去就那么几款“播音腔”,今天你用了,隔壁王老师也在用。学生听多了,压根分不清哪个课件是哪个老师做的。
课件帮的声音复刻功能,就是专门来解决这个问题的。说白了,它能让AI用你自己的声音去讲课——音色、语调、停顿习惯,全都保留。
01 为什么普通AI配音救不了你的微课?
先别急着上手操作,咱们把问题捋清楚。
过去你用AI配音,是不是这个体验:打开软件,选一个“温柔女声”或“磁性男声”,输入文字,生成。听起来是挺顺耳,但总感觉哪里不对劲——
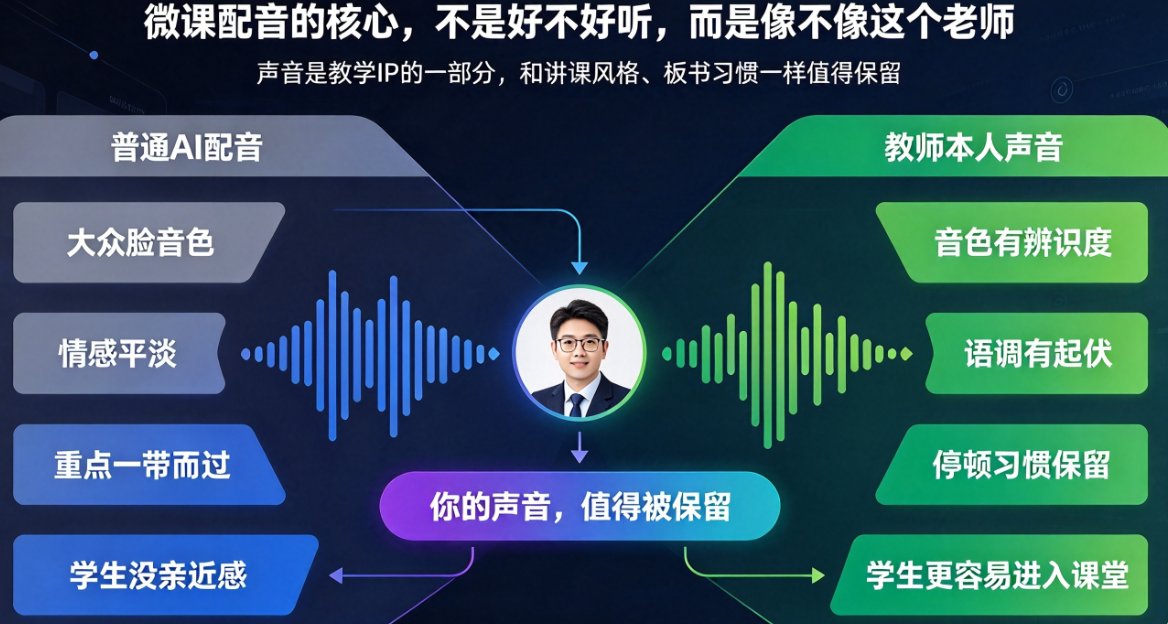
- 没有辨识度:声音是“大众脸”,放到任何课件里都适用,也就意味着放到你的课件里毫无个性。
- 情感平淡:遇到底气足的重点强调、轻声细语的案例讲解,机械TTS基本都是一带而过,节奏永远一条直线。
- 和学生没有“亲近感”:学生习惯的是你的声音、你讲课的节奏,换成个陌生的AI嗓音,注意力天然就打折扣。
说白了,微课配音的核心不是“声音好不好听”,而是“像不像这个老师在讲课”。 声音是你教学IP的一部分,和你的讲课风格、板书习惯一样值得被保留。
02 声音复刻为什么比TTS更适合教师?
声音复刻,英文叫Voice Cloning。它跟普通TTS(文本转语音)本质上是两个维度的东西:
| 对比维度 | 普通TTS配音 | 课件帮声音复刻 |
|---|---|---|
| 音色来源 | 预设音色库 | 你的真实声音 |
| 语调表现 | 平均化、缺乏起伏 | 保留个人语调曲线 |
| 停顿习惯 | 机器断句 | 学习你的停顿节奏 |
| 辨识度 | 千篇一律 | 高度个人化 |
| 学生感受 | “像在听广播” | “像老师在讲课” |
| 制作周期 | 即时生成 | 仅需5分钟样本+1次训练 |
上面这张表,核心差异就一句话:普通TTS在“发声”,声音复刻在“模仿你发声”。 它学的不只是音色,还包括你什么时候停顿、哪里加重语气、遇到重点怎么放慢语速。这些细微习惯,恰恰是学生熟悉你讲课方式的关键。
课件帮的声音复刻模型,在训练时会把你的声音特征拆解成语调曲线、音色参数、发音节奏三个维度,再合成为一套专属声音模型。你录一次讲课稿,之后任何文字稿扔进去,出来的都是你自己的“声线”。
03 实战教程:课件帮声音复刻三步走
咱们直接上手。整个过程从零开始,大概需要10分钟。
第一步:录制语音样本(1-3分钟)
打开课件帮,进入“声音复刻”功能,按提示开始录制。
别踩这个坑:别在嘈杂的环境录,也别用压缩过的微信语音。 用手机自带的录音机或电脑麦克风,找一个安静的房间,距离麦克风15-20厘米。
内容上,建议直接拿你的一节讲课稿来读。这样录音的同时,也算在备课。时长控制在1-3分钟,一次录完,不要分段拼接。 语速保持你平时讲课的节奏就好,不用刻意“播音腔”。
第二步:一键训练声音模型
录完音,点“开始训练”。课件帮会自动完成降噪、特征提取、模型训练这些技术活。整个过程你不用管任何参数,等一两分钟,模型就生成好了。
说句实在话,我第一次用的时候也担心“会不会训练出来不像我”。实际效果是:保留了我那个有点沙哑的尾音,还有我讲到重点时微微加重的语气。那种“AI味”基本感觉不到。
第三步:应用到数字人微课
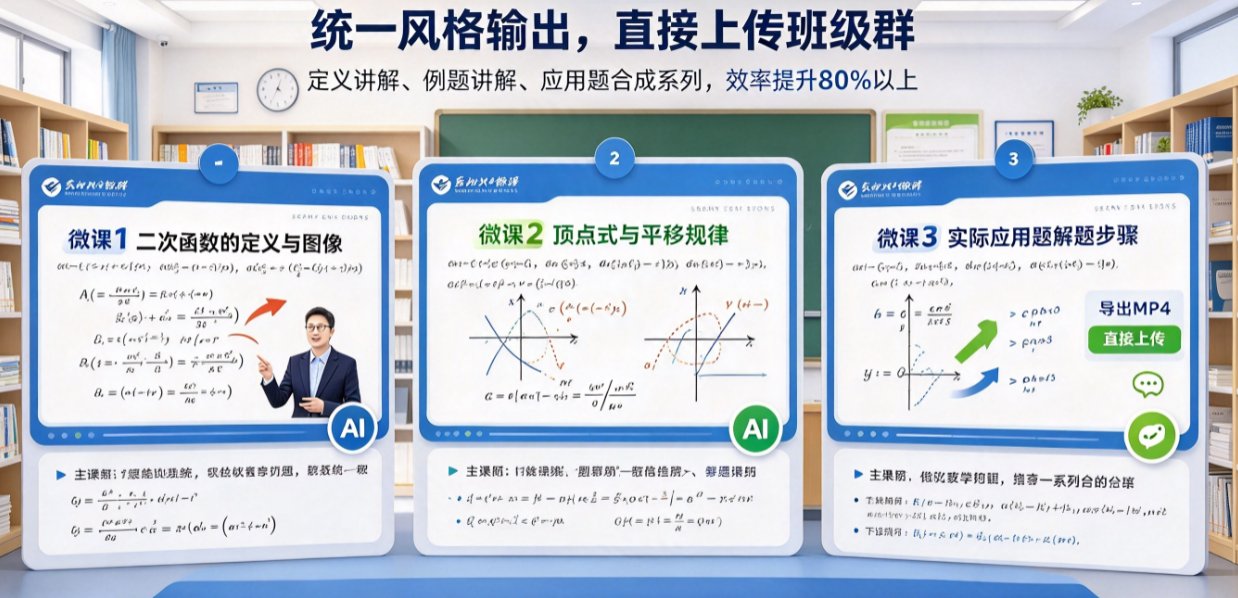
模型生成后,回到微课制作界面。在配音设置里,把你的声音模型选为默认。然后输入或导入讲课稿,课件帮的AI会自动按你的声音模型生成配音,配合数字人播报的唇形同步,就是一段以你本人音色讲课的视频。
偷偷告诉你:如果你有之前做好的PPT,可以直接用课件帮的PPT转视频功能,把旁白替换成你的专属声音,转成视频后整门课的辨识度立刻就不一样了。
04 实测说明:5分钟样本够不够?
很多老师会问:我录多长时间才够?
课件帮官方建议是5分钟语音样本即可。但根据实际操作经验,1-3分钟的清晰录音已经能达到令人满意的效果。当然,样本越长,模型对语调、习惯的捕捉越细腻。
划重点:质量比时长重要。 录音中如果你频繁卡顿、换气声太重、或者环境有回声,都会影响训练效果。宁可录一段3分钟的流畅讲课,也别录10分钟的碎片拼接。
【此处插入图表:声音复刻效果与录音时长的关系示意图】
05 声音复刻 + 数字人:教学IP的完整闭环
声音复刻单独用已经很香,但配合数字人,才是微课制作的“完全体”。
想想这个场景:你录了一段声音模型,上传一张你的照片,课件帮生成一个和你高度相似的虚拟讲师。然后你把整学期的课程讲稿导入,数字人用你的声音、你的面容,把一整个学期的微课全部“讲”完。
这解决的不只是配音问题,而是整个教学内容的IP化问题。 学生看到的是固定的、一致的讲师形象和声音,跟看一个真人老师上课没什么两样。
这和课件帮2026年主推的“数字人IP化”方向完全一致——通过声音复刻与形象定制,让每位教师拥有专属的数字分身。如果你的课程要长期运营,这个组合几乎是必选项。
避坑提示:别贪多。 刚开始别急着做十几分钟的长课。先用声音复刻做一节5-8分钟的微课,跑一遍全流程,听听效果、看看学生反馈,再逐步扩大制作规模。
06 最后:声音是微课的灵魂
做了这么多年课件,我的感受是:画面决定微课的专业度,但声音决定微课的“人味”。 学生判断一个课是不是你教的,第一反应就是听声音。
课件帮的声音复刻,本质上是在帮你(教师)把最自然的表达方式,延伸到每一个数字化场景里。它不需要你出镜、不需要你反复录制,只需要花10分钟跑一遍流程,以后所有微课、视频、互动课件,都能用你自己的声音来说话。
如果你也想告别千篇一律的AI嗓音,不妨去课件帮试试声音复刻功能。录一段你的讲课稿,剩下的交给它。
常见问题
课件帮声音复刻需要录多久的语音样本?
建议录制1-3分钟的清晰语音,内容可以是你的讲课稿或随意朗读。实测5分钟左右的样本就能达到较好的效果,音色、语调、停顿习惯都会被保留。
声音复刻和普通AI配音有什么区别?
普通AI配音是从预设音色库中选择,声音千篇一律、缺乏个人辨识度。声音复刻基于你的真实声音样本训练专属模型,生成的语音保留你的音色、语调、停顿习惯,听起来就像你本人在讲课,更具亲和力和辨识度。
课件帮声音复刻的操作流程复杂吗?
不复杂,共三步:录制语音样本、一键训练声音模型、在数字人微课中应用。全程无需专业设备,用手机或电脑麦克风即可,平台会自动处理降噪和模型训练。
声音复刻可以用在哪些场景?
可以用在微课配音、数字人播报、PPT转视频的旁白、企业培训视频、知识科普视频等场景。只要是在课件帮平台生成的视频内容,都能无缝使用你克隆的专属声音。
声音复刻后如何保证自然度?
关键在于录音质量:尽量选择安静环境、保持正常语速和音量、一次录完不要拼接。课件帮的训练模型会保留你的语调曲线和停顿习惯,生成的声音比机械TTS自然度高很多。