教师不想真人出镜?课件帮声音复刻让AI数字人用你的声音讲微课
一、深夜十一点,你还在对着摄像头重录第 8 遍
把镜头擦干净,深呼吸,点下录制键。说到第二分钟卡壳了。删掉重来。第三分钟,表情僵了。再删。等录完这一遍,已经凌晨十二点半。
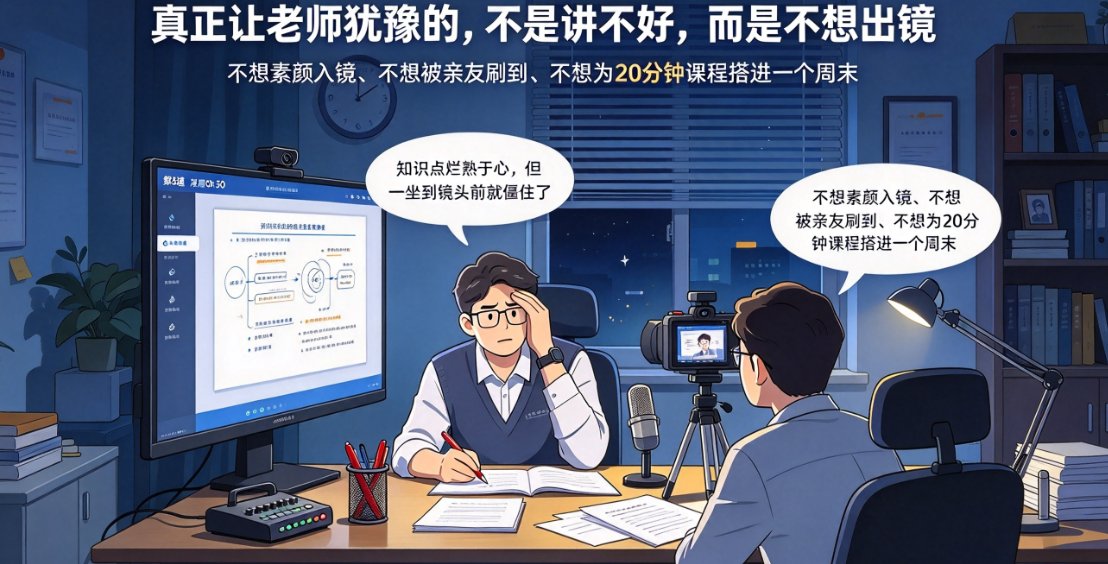
这是不少老师做微课的真实状态:明明知识点烂熟于心,但一坐到镜头前,整个人就僵住了。而真正让老师们犹豫的,不是讲不好,而是不想出镜。
你不想穿着睡衣顶着素颜出现在视频里,不想让亲戚朋友刷到你在讲台上比划的样子,更不想为了录 20 分钟课程,搭进去一个周末。但微课又不能不录——线上教学、翻转课堂、评优课材料,哪一样都离不开视频。
说句实在话,这件事在 2026 年早就有了更聪明的解法。做微课,不一定要你亲自出镜,但一定要用你的声音。 思路很简单:做一个长得像你的数字人,再用你自己的音色配音——学生听着熟悉的声音,看着熟悉的面孔,没人觉得这叫偷懒。
课件帮(kejian365.com)把这两件事做成了三步操作:上传照片生成形象、录几分钟语音克隆音色、粘贴讲稿一键成片。下面这份全流程实测,你照着抄作业就行。
二、声音不像自己?90% 的问题出在录音这一步
先别急着打开软件。做数字人微课前,最重要的一步其实是「喂声音」。 很多老师一开始没当回事,随便清了清嗓子读了两段课文就上传,结果生成的 AI 声音一出,评论区一片「这是谁?」
这不是工具的问题,是录音素材没给够。
1. 录 1 分钟和录 5 分钟,差距比你想的大
课件帮的声音复刻功能,最短支持 1 分钟语音样本。但说实话,1 分钟只能捕捉你的音色底色,5 分钟才能学到你的语气流动。 你平时上课说「同学们注意看,这道题的坑在这里」时的那种停顿和强调,AI 是靠着足够长的样本才能学会的。
别踩这个坑:别为了赶时间随便对付 1 分钟。找个安静时段,拿起手机,把明天要讲的课从头到尾说一遍,哪怕磕巴也没关系,这才是 AI 最需要的「血肉素材」。
2. 环境噪音是音色克隆的头号杀手
开着空调、窗外偶尔按喇叭,这些声音都会被 AI 当成「你的音色特征」一起学走。等生成完你会发现,AI 说话时伴着一层沙沙的底噪,怎么降噪都去不干净。
偷偷告诉你:手机自带录音就够用,关键是环境要安静。 选一个衣帽间或者铺了地毯的卧室,关上门窗,手机放桌上,离你 20-30 厘米,这样录出来的底噪最小,克隆效果最好。
3. 让讲稿「说人话」,AI 才能学得像你
很多人写讲稿用的是书面语,「综上所述」「由此可见」这类词连你平时上课都不怎么说,AI 学走以后,你听起来反而觉得不像自己。
说白了就是:讲稿怎么口语化怎么写。 把你平时上课的「咱们」「大家想想看」「这部分先记住」口头禅都写进去。AI 不光能克隆音色,还能学会你的语气习惯,讲稿越像你说话,生成效果越像你本尊。
课件帮的 声音复刻三步指南 里有个细节很实用:录完的音可以直接在平台上试听对比,觉得不像可以重新录,不用浪费任何时间。
三、照片 + 语音,5 分钟生成你的专属数字人分身
形象、声音素材都备齐了,接下来进入正题。课件帮的操作流程,比发一条朋友圈复杂不了多少:
第一步:上传一张正脸照片
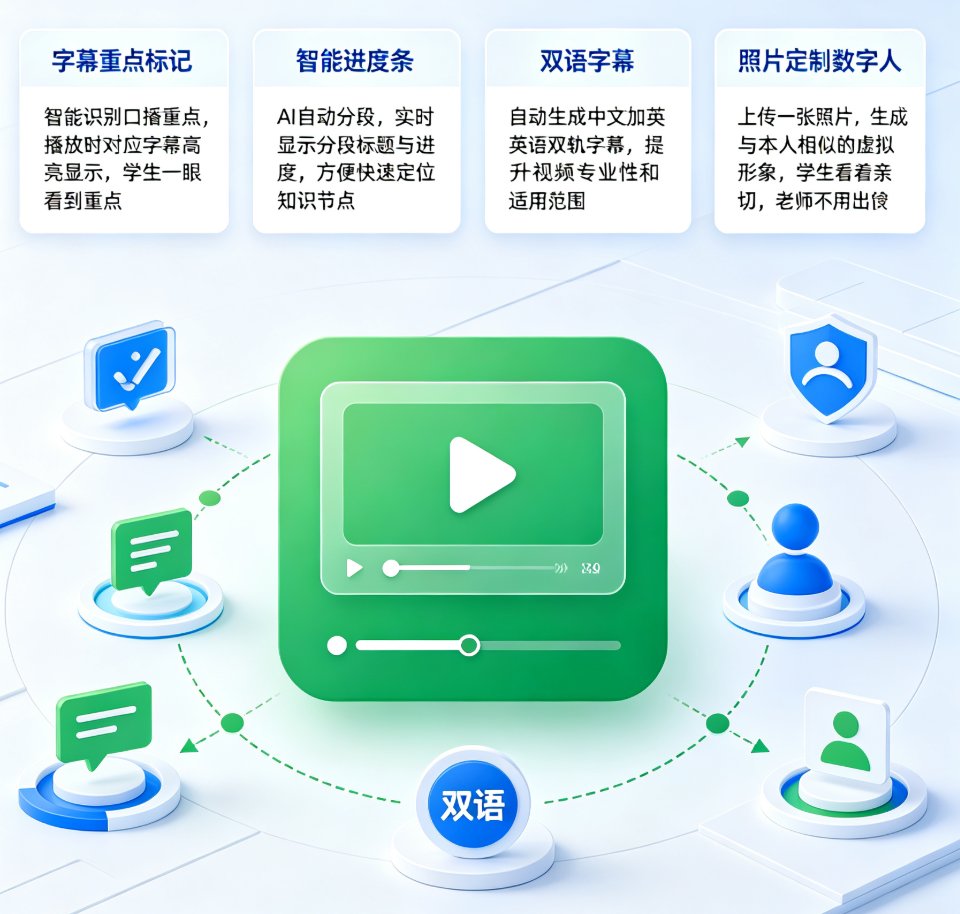
进「数字人定制」页面,上传一张光线充足、正脸朝向的清晰照片。系统会自动识别五官特征与面部轮廓,生成 1:1 还原的 2D 数字人形象,整个过程不到 5 分钟。
如果有 10 秒以上的真人视频素材,也可以直接上传——AI 会提取更多动态细节,比如微表情和自然动作,数字人看起来会更灵动。
别踩这个坑:别拿十年前的厚滤镜自拍。 AI 会认真「学习」你的五官,你磨了皮,它也会把磨皮后的脸当成长相的一部分。选一张最近拍的、光线正常的生活照就最好。
第二步:录制或上传语音样本
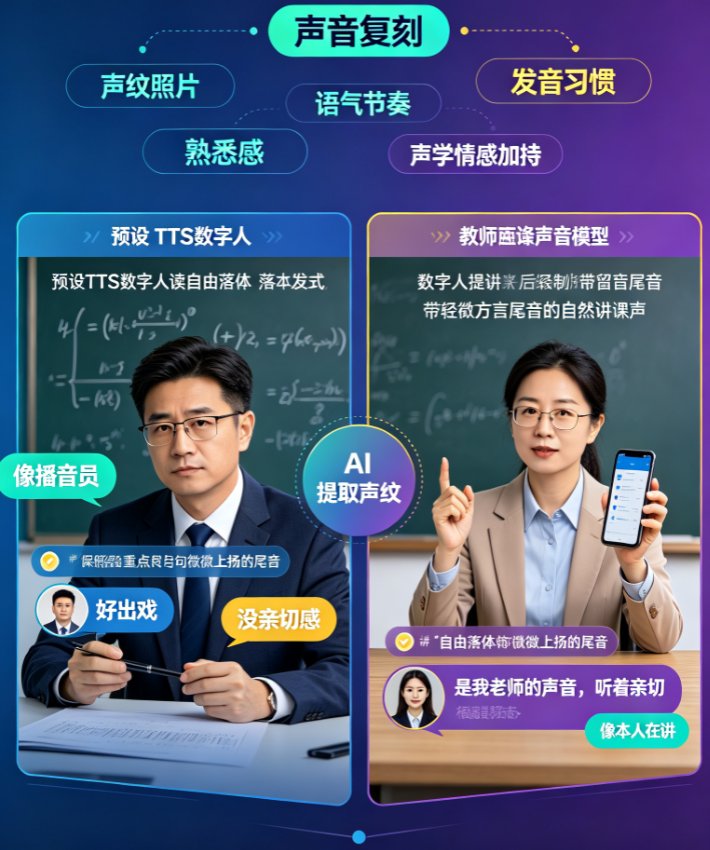
在「声音复刻」功能区,上传刚才录好的 3-5 分钟语音。课件帮会自动提取你的音高、语速、停顿习惯、平翘舌口音等声纹特征,生成属于你的专属音色模型。
相比那些只能选系统内置配音的工具,用自己的音色讲课,学生听到的依然是那个熟悉的老师,只不过这次是数字人在替你开口。 想要深入了解声音复刻的技术与操作细节,可以看看这篇数字人声音复刻实战解析。
第三步:粘贴讲稿,一键生成微课视频
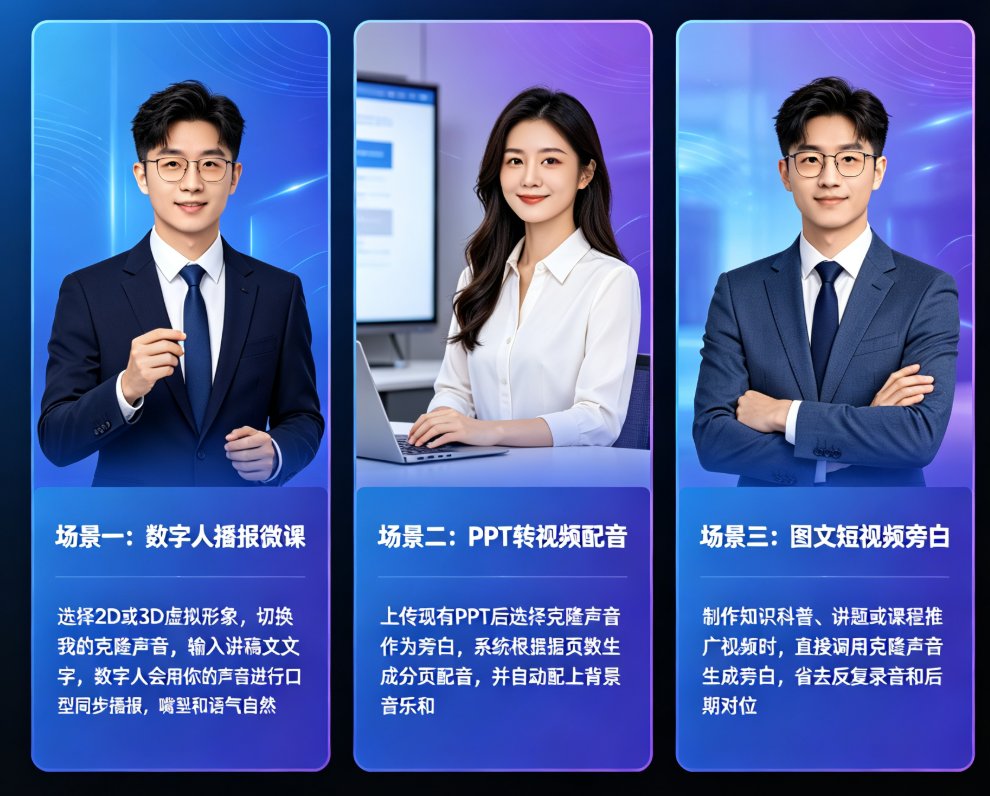
把准备好的讲稿粘贴进去,或者直接上传 PPT 课件。课件帮会自动完成文案口语化优化、配图匹配、动画生成,然后数字人会照着讲稿开口讲课,口型与声音自动同步。
整个过程,你做的只是把想讲的内容放进去。剩下的,AI 替你搞定。
四、真人出镜 vs 数字人代劳:算一笔时间账
光说概念可能还不直观,咱直接看数据。以制作一节 15 分钟的微课为例,对比一下王老师前后两种方式的投入:
| 对比维度 | 真人出镜录制 | 用课件帮数字人 + 声音复刻 |
|---|---|---|
| 准备环境(灯光、背景、设备) | 30 分钟 | 无需准备 |
| 录制过程(含卡壳重录) | 2-3 小时 | 录语音样本 5 分钟 |
| 剪辑(去口误、加字幕、加配乐) | 1-2 小时 | AI 自动完成 |
| 返工重录 | 需要重新换装、布景、重录 | 修改讲稿后一键重新生成 |
| 心理负担(发型、妆容、镜头恐惧) | 高 | 零 |
| 总计耗时 | 4-5 小时 | 约 30 分钟 |
一节微课,从 5 小时压到 30 分钟,省下来的时间你可以多批 100 份作业。 当然,这不代表完全没用真人出镜的必要——直播课、面授讲解、需要你亲自演示手势的实验课,该出镜还是得出。但在录播微课、习题讲解、知识科普这类场景里,数字人分身完全够用。
关于不同场景怎么选,这篇数字人微课应用的 5 大教学场景 里拆得比较细,值得翻一翻。
五、低成本、高拟真、学科适配,这三件事如何同时成立
数字人微课在国内发展了几年,过去总被人吐槽「一眼假」「声音机械」。2026 年再看,情况已经完全变了。
现在的数字人已经不是一张会动的照片,而是有微表情、有肢体动作、带着你声音温度的虚拟讲师。 这背后靠的是三件事同时进步:
- 音色克隆精度提高:以前是「听到是女的在念 PPT」,现在是「连语气里的欲言又止都能学走」;
- 口型同步自然化:数字人的嘴型变化、眨眼频率、说话时微微侧头的动作,已经贴近真人直播状态;
- 学科场景适配:课件帮的模板和动画效果会根据学科自动调整,数学课的板书演示、语文课的段落标注、科学课的实验模拟,各有各的呈现逻辑。
对所有不想出镜但又希望微课有真人感的老师来说,这确实是个机会。想系统了解 2026 年数字人教师的应用趋势,可以看这篇情感智能时代数字人教师发展报告。
六、除了微课,你的数字分身还能干很多事
很多人以为数字人只能做微课,其实它还能帮你扛不少重复工作:
- 录制习题讲解视频:把学生问得最多的 10 道题做成系列课,让学生反复看,不用你反复讲;
- 制作家长会 / 招生宣传视频:不用再对着摄像头正襟危坐,用数字人 + 你的声音就能录制一段亲切的欢迎致辞;
- 打造教师个人 IP:持续输出知识短视频,积累学生的信任感,不会让你因为没时间出镜而断更;
这些都是同一个能力点的延伸——把个人的教学表达,沉淀为可复制、可扩展、可规模化的数字资产。 关于这一点,数字人 IP 化趋势 这篇文章讲得很透。
七、写在最后的实在话
做老师,最宝贵的永远是时间和状态。
数字人不是要取代你,而是替你扛住重复与出镜的压力,让你把精力放在更有价值的地方——教学设计、学生辅导、教研创新。课件帮要做的,就是把这件事的门槛降到最低:照片、语音、讲稿,三步而已。
别再对着摄像头反复重录了,你的分身,已经准备好替你开讲。
常见问题
课件帮声音复刻需要录多久的语音?
最短录 1 分钟即可生成基础音色,但要复刻出你平时上课的抑扬顿挫和停顿习惯,建议录 3-5 分钟,带点情绪、多点口语化表达,克隆出来的声音会更像你本尊。
用课件帮数字人做微课,学生会觉得假吗?
比起冷冰冰的纯 PPT 配音,用你自己的音色驱动的数字人,天然带着学生熟悉的语气和节奏,代入感会强很多。配合口型同步和微表情动作,大部分学生根本不会注意到这是 AI 做的。
我不会剪辑视频,能用课件帮完成整个微课制作吗?
完全可以。课件帮的操作基本是三步:上传照片或视频生成数字人形象、录一段语音克隆音色、粘贴讲稿或上传 PPT 后一键生成视频。不需要任何剪辑基础,平台会自动匹配画面、字幕、转场和背景音乐。
课件帮声音复刻适合哪些教学场景?
适合录微课、做翻转课堂视频、出镜讲解习题、制作家长会或招生宣传视频,甚至打造教师个人 IP。凡是原来需要你对着摄像头录制的场景,都可以用数字人分身替代,保留熟悉的声音,不用再纠结出镜状态。