教师不想真人出镜?课件帮数字人定制+声音复刻打造专属AI分身
深夜十一点,刘老师对着摄像头第N次删掉了刚录的视频
妆容花了、背景杂乱、语速卡壳,这已经是今晚第五遍重录了。第二天有早课,但她不想用昨天的课件将就——那门《教育心理学》要讲皮亚杰,光靠文字和图片根本撑不起课堂效果。
屏幕里的自己眼神闪躲,她叹了口气:如果,能有一个不用出镜的我,替我讲课就好了。
这不是她一个人的执念。翻翻各个教师群,「出镜焦虑」几乎是公开的秘密——怕上镜胖十斤、怕口误不断重录、怕隐私暴露在公开课程里、怕录一节课磨掉半天时间。但课程又不得不录,微课要求越来越高,学生也越来越吃「互动感」这一套。
所以今天,咱就聊聊那个更聪明的解法:课件帮的数字人定制 + 声音复刻组合拳。
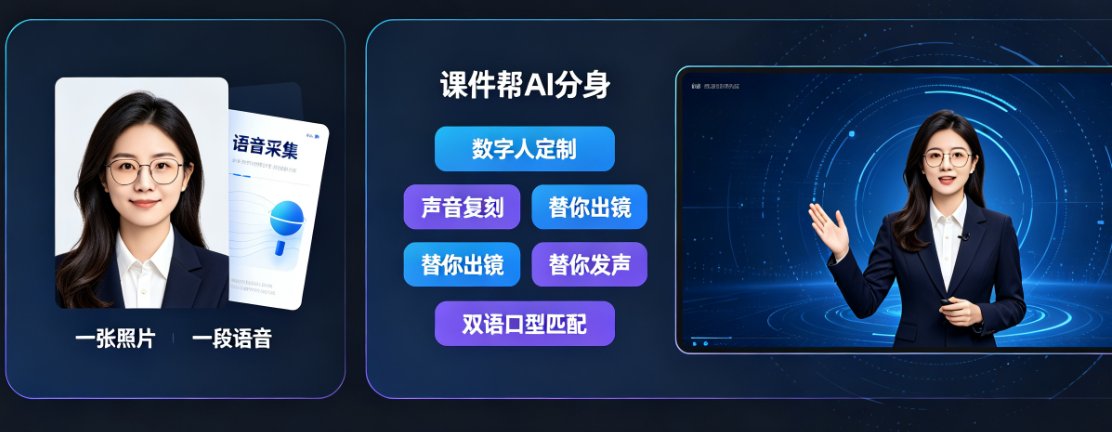
在正文开始前,先给各位一句话定心丸:你不需要学会做视频,甚至不需要学会写脚本——只需一张照片、一段语音,就能拥有一个替你出镜、替你发声的专属AI分身。
一、不想出镜,真的可以用「分身」解决吗?
先讲个真实场景。
杭州某职业院校的王老师,去年接了个「职教出海」项目,要在两周内产出三门双语微课。她不是没有过真人出镜的想法——但录了三次,每次都因为外语口音和状态不稳定返工,最崩溃的一次,一个十分钟的课程磨了整整一天。
后来她换了个思路:用课件帮生成自己的数字人分身,声音用克隆出来的自己的音色。结果一周时间,三门双语课程全部交付,每门课程只花了两小时左右。 更惊喜的是,数字人支持12国语言的口型自动匹配,她甚至不用自己说英语,系统就能让数字人用标准发音讲课。
这件事说明什么?
真人出镜最大的障碍不是能力,而是效率与心理门槛。 AI数字人不是要替代你,而是替你扛住那些重复、琐碎、高压力的出镜环节,让你把精力留在教学设计本身。
想先体验一下数字人播报的效果?可以看看这篇关于数字人播报技术演进的文章:2026数字人播报技术演进:课件帮如何让讲师虚拟分身规模化生产微课?
二、三步走:照片 + 语音,生成你的专属分身
课件帮做这件事,比你想象中简单。整个流程就三步:
第一步:上传素材,生成数字人形象
你只需要准备一张正脸照片(或者一小段视频,10秒就够),剩下的全部交给平台。
系统会自动识别你的五官特征、面部轮廓,生成一个1:1还原的2D数字人形象。比起市面上那些只有一张脸在动的「照片级」数字人,课件帮的数字人有自然的眨眼、点头、微笑等微表情,肢体动作也会随讲解内容轻微摆动,不是一尊蜡像,是有「活感」的虚拟讲师。
说句实在话,初次看到自己的数字人分身时,愣了一下的老师不在少数——像,真的像。
第二步:5分钟语音,克隆你的声音
声音复刻更是省心。你只需用手机录一段1-5分钟的语音,可以是平时讲课的音频,也可以是随意读一段文字。课件帮会自动提取你的音色特征:音高、语速、停顿习惯、平翘舌口音……
克隆后的声音,说话语气、语调、停顿,跟你本尊几乎没差。 学生听到的,依旧是那个熟悉的老师声音,只不过这次声音是从数字人口中说出来的。
这解决了什么?解决了「声音不像自己」的尴尬。 很多老师担心AI配音太机械,学生一听就出戏。但用你自己的音色讲课,熟悉感立刻回来了。
想知道具体怎么操作?参考这篇文章:2026年数字人微课个性化趋势:声音复刻+形象定制,课件帮如何让每位教师拥有专属数字人?
第三步:输入讲稿,一键生成微课视频
形象、声音都已就位,接下来就简单了。
把讲稿粘贴进去,或者直接上传PPT课件,课件帮会自动完成文案优化、配图匹配、动画生成,然后数字人会照着讲稿开口讲课,口型与声音自动同步。
整个过程,你做的,只是把想讲的内容放进去。
三、声音不像自己?问题多半出在这3个地方
用了声音复刻的老师,偶尔也会吐槽:「AI讲出来,味道好像还是不太对。」
别急,90%的情况不是工具不行,而是素材没给够。
1. 语音样本太短,语气特征没被捕捉到
说句实在话,1分钟语音和5分钟语音,克隆出来的差别很大。 前者的语气往往是平的,后者才能捕捉到你讲课时的抑扬顿挫。
别踩这个坑: 别为了省时间只录1分钟干巴巴的课文朗读。多录几分钟,讲讲你平时上课怎么说话,带点情绪、加点手势。声音越「有戏」,克隆出来才越像你。
2. 环境噪音太重,声音底噪没滤干净
录音的时候旁边开着风扇、窗外有车声,AI会把这些噪音也当成「音色特征」学走。
偷偷告诉你: 找个安静的角落,用手机自带录音就行,关键不是设备,而是环境。后期有降噪功能能救一部分,但源头干净比什么都强。
3. 讲稿太「书面」,不像你上课说的话
克隆的声音会保留你的语气习惯,但如果讲稿是标准的书面语,AI再怎么努力也变不成你平时上课的口语状态。
说白了就是: 让讲稿「说人话」。多写短句,多用「咱们」「大家想想看」这类口头禅,AI会学得更像你平时的样子。
声音复刻这事,想深入研究的可以看这篇:2026年数字人教师“情感智能”突破:课件帮如何让虚拟教师更懂学生?
四、真人 vs 数字人:一次直观的效率对比
光说概念没用,直接上数据。下表是王老师那周的真实记录:
| 对比维度 | 真人出镜录制 | 数字人分身(课件帮) |
|---|---|---|
| 单次课程耗时(含返工) | 3-4小时 | 40-60分钟 |
| 一次录制可复用次数 | 1次 | 无限次 |
| 多语言适配 | 需另找配音 | 一键切换12国语言 |
| 状态受情绪/状态影响 | 高 | 完全可控 |
| 需要化妆/布景/设备 | 是 | 仅需手机与照片 |
| 隐私保护 | 完全暴露 | 可选择不露脸 |
这份数据背后,是90%的时间节省,是无限次的复用,是彻底放下的出镜负担。
如果你也正在为微课制作成本发愁,不妨看看这篇:2026教培降本增效新工具:课件帮AI如何让微课制作成本降低80%?
五、隐私与版权:你的分身,只属于你
担心数字人被乱用?这个顾虑很正当。
课件帮的数字人定制服务,在生成专属形象和声音时,会和每位用户签署授权协议,明确数字人的使用权和归属权属于本人。 平台给你的账号是独立的,上传的素材和生成的视频内容都存储在自己的数据库里,账号之间物理隔离。
换句话说:你的分身,只有你能用,别人碰都碰不到。
而且,如果你不想用自己的声音,平台也提供多音色库供选择;不想用自己的形象,也可以选平台内置的虚拟讲师。灵活度很高,总有一款适合你。
关于数据安全这块,想了解更多的可以看这篇:2026年AI课件数据安全新趋势:混合云部署与本地化,课件帮如何满足不同机构安全需求?
六、别只把数字人当「替身」,它还能帮你做更多
数字人定制 + 声音复刻这件事,如果你只用来「不出镜录微课」,其实有点浪费。
它真正的价值,是把你从重复劳动中解放出来,去做更有创造力的教学。
比如:
- 批量生成系列课程:一次定制,无限次生成,同一门课可以切换不同案例、不同讲法。
- 多语言课程出海:数字人自动匹配口型,配上中英双语字幕,国际化课程轻松搞定。
- 企业培训标准化:保证每次培训讲师「状态」完全一致,内容质量可控。
- 知识科普短视频:竖版视频一键生成,发抖音、视频号都行,反正不用出镜。
- 多角色对话教学:你可以用克隆的声音扮演「老师」,再用另一个音色扮演「学生」,生成互动式对话微课。
这些都是同一个能力点的延伸——把个人的教学表达,沉淀为可复制、可扩展、可规模化的数字资产。
关于IP化运营,这篇值得一读:2026数字人IP化趋势:课件帮如何用声音复刻与形象定制打造专属教学助手?
七、写在最后的实在话
做老师,最宝贵的永远是时间和状态。
数字人不是要取代你,而是替你扛住重复与出镜的压力,让你把精力放在更有价值的教学设计与师生互动上。 课件帮要做的,就是把这件事的门槛降到最低——照片、语音、讲稿,三步而已。
别再对着摄像头反复重录了,你的分身,已经准备好替你开讲。
常见问题
课件帮数字人定制和声音复刻需要哪些素材?
数字人定制只需上传一张清晰的正脸照片(或短视频素材),声音复刻则需要录制一段约1-5分钟的清晰语音样本。课件帮会基于这些素材自动训练生成专属数字人形象与克隆音色,无需专业设备,普通手机拍摄即可满足需求。
定制数字人后,声音和形象能保持一致吗?
可以。课件帮的声音复刻与数字人形象定制是配套功能——平台会用克隆出来的个人音色驱动数字人,并根据音频内容自动匹配口型,保证音画同步自然。同时支持多语言切换,适合双语教学或国际化课程制作。
用AI数字人做的微课,学生会不会觉得假?
相比冷冰冰的纯PPT配音,定制数字人带着你的真实音色和专属形象,已经能显著提升代入感。课件帮支持绿幕输出,方便你在后期添加特效、板书或场景;配合情感表达功能,虚拟教师的语气、表情和肢体动作也更贴近真人授课状态,学生接受度远比想象中高。
课件帮数字人定制适合哪些教学场景?
覆盖范围很广:微课录制、翻转课堂、企业培训、知识科普短视频、讲题视频等都能用。尤其适合不想露脸但又希望保留个人IP的教师,以及需要批量产出系列课程的培训团队——一次定制,长期复用。


